JavaScript 模块演化历程

[TOC]

前端模块化

前端模块化主要解决两个问题:命名空间冲突和文件依赖管理

JavaScript 模块演化历程

原始时期

直接定义依赖

1
2
3
4
5
var a = 10
function funcA () {}

var b = 20
function funcB () {}

在原始时期,“模块化”是通过定义函数和共享变量,这种做法最明显的缺点就是污染全局变量,后面的重名的变量会覆盖前面使用的变量,各个模块之间也没有明显的依赖关系。

命名空间

1
2
3
4
5
6
7
8
9
var objA = {
a: 10,
funcA: function () {}
}

var objB = {
b: 20,
funcB: function () {}
}

比较多的组织方式的可能会使用命名空间来表示变量,使用对象来约定变量的作用域

闭包模块化

1
2
3
4
5
6
7
8
9
var module = (function(module, $) {
function privateMethod () {}

module.moduleProperty = 1
module.moduleMethod = function () {
// dosomething
}
return module
})(window.modules || {}, jQuery)

通过立即执行函数(IIFE),外部函数无法调用到里面的 privateMethod方法,解决了全局污染问题。

同时这种模式还可以将模块拆分,在闭包内可以调用或继承其他子模块、添加新的变量和方法,最后返回新的模块。

同样这种模块化的方式缺点也很明显,如:

  • 为了在模块内调用其他全局变量,必须显示注入全局变量,例如这里的jQuery
  • 当跨文件使用模块时,必须将模块挂载到全局变量(window)上
  • 没有解决如何管理这些模块的问题,各个模块之间的依赖关系需要通过 script 的引入顺序来保证

CommonJs

概述

从 1999 年开始,js模块化的探索都是基于语言层面上的优化,真正的改变要从2009年Commonjs的引入开始,后面的Node.js就是采用了CommonJs模块规范,其约定如下:

  • 每个文件都是一个模块,拥有自己的作用域。一个文件中定义的变量、函数、类,总是私有的,对其他文件不可见。
  • exports指向module.exports,可以通过exports向module.exports对象中添加变量
  • require用于加载模块(核心)
  • 每个模块内部,module变量代表当前模块。这个变量是一个对象,是Module的一个实例,它的exports属性(即module.exports)是对外的接口。加载某个模块,其实就是加载的该模块的module.exports对象

特性

  • 所有模块都运行在模块作用域,不会污染全局作用域
  • 模块加载的顺序,按照代码中出现的顺序执行(同步执行)
  • 模块输入的值是复制(基础类型为复制,引用类型为值引用),模块可以多次加载,但是只会在第一次加载时运行一次,然后运行结果就被缓存起来了,以后再加载,就直接读取缓存结果。想要让模块再次运行,必须清除缓存。

不足

  • 缺少模块封装的能力

CommonJs规范中每个模块都是一个文件,这意味着每个文件只有一个模块。这在服务器端是可行的,但是在浏览器端会不俗很友好,浏览器中需要做到尽可能少的发起请求,通常一个文件中会有多个模块。

  • 使用同步的方式加载依赖。

在浏览器中由于JS的加载会阻碍渲染,同步加载可能会导致白屏问题,对于用户体验是致命的。

  • 导出语法问题

CommJs规范中使用了export的对象来暴露模块,将需要导出的变量附加到export上,但是要导出一个函数却只能使用 module.export,这种语法容易然人困惑。

其他疑问点

  • 模块的缓存

第一次加载模块时,Node会缓存模块。之后在加载该模块时,直接从缓存中取出该模块的 module.exports 对象

如果想要多次执行某个模块,可以在每次模块加载之前可以删除缓存的模块(require.cache中的缓存),代码如下:

1
2
3
4
5
6
7
// 删除指定模块的缓存
delete require.cache[moduleName];

// 删除所有模块的缓存
Object.keys(require.cache).forEach(function(key) {
delete require.cache[key];
})
  • 模块的加载机制

CommonJs模块输出的是值的拷贝(基础类型为复制,引用类型为值引用)。也就是说,一旦输出一个值,模块内部的变化就不会影响到这个值

  • 模块的循环依赖

CommonJS模块的重要特性是加载时执行,即脚本代码在require的时候,就会全部加载并执行。当出现某个模块被”循环加载”,就输出已执行的部分,还未执行的部分不会输出

在模块内部,可以通过 require.main 属性,判断模块是直接运行,还是被调用执行,从而检测是被其他模块依赖。

AMD

背景

CommonJS规范在浏览器端并不太适用,主要得原因是 require 模块是同步加载的,这在服务器端问题不大,因为所有的模块都存放在本地,可以同步加载完成启动服务,加载耗时较短是可以接受的。

但这对于浏览器却是有待考虑的问题,模块加载等待时间和文件大小以及网速相关,可能要等待很长时间,这段时间内浏览器则处于“假死”状态,失去相应或出现“白屏”现象。

所以,浏览器端的模块就只能采用“异步加载”的方式,前端社区也出现AMD模块规范,用于满足在浏览器端模块的“异步加载”场景

概述

AMD(Asynchronous Module Definition),即异步模块加载机制,该规范采用异步方式加载模块,模块的加载不影响后面语句的执行。

模块定义

AMD规范定义了一个 define 关键字,用来定义和加载模块

1
define(id?, dependencies?, factory)

参数:

  • id:模块标识,可以省略
  • dependences:所依赖的模块数,可以省略
  • factory:模块的实现,通常是一个对象

模块加载

AMD规范中也使用require全局方法加载模块

1
require([dependence], callback)

但AMD规范中的require不同于CommonJs规范,这里接受两个参数:

  • dependences 需要配置前置的依赖

只有所有前置依赖都加载完毕才会触发回调函数,dependences中的依赖是通过动态创建script和事件监听的方式来异步加载模块,解决了CommonJs同步加载耗时的问题

  • callback 所有模块加载完毕之后的回调函数

当前置依赖的所有模块加载完毕之后,会按照前置依赖的顺序作为callback的参数,在回调函数中就可以正常调用这些模块

代表作

RequireJs

UMD

背景

对于javaScript社区中中的各种不同规范的分裂状态,需要整合实现一个通用模块规范,由此促使UMD规范的出现

概述

UMD(Universal Module Definnition),即通用模块定义模式,用来解决CommonJs规范和AMD规范的代码在服务端和浏览器端不通用的问题

实现

UMD规范实现比较简单,通过检测不同的环境使用不同的规范打包就可以了,大概处理流程如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
(function (global, factory) {
// CommonJS 规范
typeof exports === 'object' && typeof module !== 'undefined' ? module.exports = factory() :

// AMD规范
typeof define === 'function' && define.amd ? define(factory) :
(global = global || self, global.myBundle = factory());
}(this, (function () {
const main = () => {
return 'hello world';
};

return main;
})))

ES Module

背景

不管是CommonJS规范,还是AMD规范,都是前端社区实现的模块加载方案,对于js本身而言,始终没有实现与模块相关的功能,这就促使了ECMA对于js的模块规范纳入考虑之中

概述

相对于CommonJs和AMD两种比较流程的社区模块加载方案,前者主要用于服务器端,后者主要用于浏览器端,ES2015终于在语言标准层面上,实现了模块功能:ES Module模块规范,而且语法更加简洁,更加人性化。

ES Module模块规范主要由两个命令构成:

export和import

export命令用于规定模块的对外接口,

import命令用于输入其他模块提供的功能。

特性

Es6的模块不是对象,import命令会被JavaScript引擎解析,在编译时就引入模块代码,而不是在运行时加载,也正是因为如此,才使得静态分析成为可能,主要特性如下:

  • ES Module会对静态代码分析,即在代码编译时进行模块的解析加载,在运行时之前就已经确定了依赖关系
  • ES Module是动态引用,变量不会被缓存,而是成为一个指向加载模块的引用,只有在真正取值的时候才会进行计算

其他疑问点

  • Es Moduel加载规则

ES Module在编译时就会生成一个依赖树,依赖关系则是源于每一条“import”语句

通过这些“import”语句,浏览器或Node.js会从依赖树的入口开始,沿着每条“import”语句找到对应的模块代码,但是浏览器不能直接使用这些文件,所有的文件都必须转换为一系列的称为“Module Reacord”(模块记录)的数据结构(类似于AST),Module Record会记录每个模块的内部状态信息和依赖关系。

关于 ES Module 模块加载的详细过程可以参考文章:ES module工作原理,也可以查看官方文档:ECMA 16.2 Modules

  • Es Module循环依赖

A.js

1
2
3
import { counB } from './B.js'
console.log('A counB:', counB)
export const countA = '你好,我是A'

B.js

1
2
3
import { counA } from './A.js'
console.log('B counA:', counA)
export const countB = '你好,我是B'

当出现上面的情况时,就出现了 ES Module 的循环依赖问题,这其实是ES Module的模块实例的加载状态问题

如前面所描述,在编译解析 ES Module 时,模块内部会生成一个 Module Map 的数据结构,用来记录 Module 当前状态,而在模块解析完毕时,会获取“Module Record”(模块记录)信息,导出相关数据。

而当模块没有解析完成时,则被标记为Fetching状态,不做任何处理,也就不会导出任务数据,继续编译后面的代码。

如当加载A.js模块时,由于A模块依赖了B模块,在遇到 import 时,进入B模块进行解析,而在B模块中又发现导入了A模块中的 counA,由于A模块并没有解析完毕,所以不会导出任何内容,所以这里就会报错:

‘

这也是ES Module模块和CommonJS模块的区别

  • CommonJs vs ES Modules

CommonJs规范和ES Module规范特性对比如下:

  • CommonJS模块是“运行时加载”,而ES Module则是“编译时加载”
  • CommonJS模块输出的拷贝(基础类型是拷贝,应用类型是值引用),即一旦输出一个值,模块内部的变化不会影响到这个值。而ES Module模块输出的是引用,只有在使用的时候才重新计算

总结

JS的各个模块规范的出现都是基于当时需求的沉淀实现,可以更好的帮助开发者解决前端领域问题,而为了能够减少服务端和浏览器端的差异,Node.js和浏览器都实现了支持ES Module模块规范,让javaScript开发开更加友好。

参考文章

Node ORM Sequelize 小记

图片地址:https://global.uban360.com/sfs/file?digest=fide187c6cabd9211c3e29dfabd9384faeb&fileType=2

[TOC]

前言

Sequelize 是 Node.js 中常用的 ORM 库,其作用就是对数据库表和Js对象字段映射,让我们能够通过面向对象的方式去查询和操作数据库。

正文

Sequelize支持 MySQL、PostgreSQL、SQLite 等很多数据库,在使用时可以根据自己环境做相应配置。

我们使用的是mysql数据库,使用阿里的eggjs node服务端框架,本篇文档更多介绍项目使用上需要注意的点,关于 mysql 和 sequelize 的基础内容可以查看官方文档:
mysql
sequelize

数据库配置

咱们使用的egg框架,在使用时需要安装sequelize依赖和mysql驱动

1
cnpm i egg-sequelize mysql2 -S

在 config/config.js中添加并启动 sequelize 插件

1
2
3
4
sequelize: {
enable: true, // 启用插件,false 表示禁用此插件
package: 'egg-sequelize',
},

启用 sequelize 映射mysql数据库,所以还需要配置mysql,在 config/config.default.js 添加配置信息,针对不同的环境配置中配置不同的数据源地址,可以查看 egg Sequelize 文档,也可以参考我们另一篇文章:eggjs 入门和使用 :

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
// sequelize 配置
config.equelize = {
dialect: 'mysql',
host: '127.0.0.1', // 连接的数据库主机地址
port: 3306, // mysql服务端口
database: 'demo', // 数据库名
username: 'root', // 数据库用户名
password: 'root', // 数据库密码
define: { // model的全局配置
freezeTableName: true, // 防止修改表名为复数
underscored: true, // 自动转换字段为snake_case版本
timestamps: false, // 取消时间戳
// paranoid: true, // 偏执表
},
timezone: '+8:00', // 由于 ORM 用的UTC时间,这里必须加上东八区,否则取出来的时间相差8小时
dialectOptions: { // 让读取 date 类型数据时返回字符串而不是UTC时间
dateStrings: true,
typeCast(field, next) {
if (field.type === "DATETIME") {
return field.string();
}
return next();
}
},
// 连接池
pool: {
max: 5,
min: 0,
acquire: 30000,
idle: 10000
}
};

在 sequelize 配置 mysql 数据源时,有几项需要特别注意:

  • freezeTableName

freezeTableName默认值是false,表示sequelize连接数据库时默认会将数据表名映射成复数形式,如 sequelize 定义的表 user,映射到 mysql 数据库表 users,这里配置为 true 禁止复数形式。

  • underscored

underscored比较好理解,表示在sequelize定义数据表时,字段会默认映射到 mysql 表中的下滑线表示的字段,如classId 会映射成 class_id。

  • timestamps

timestamps是配置时间戳字段,当为true时,会自定映射数据库表中的 created_at、updated_at和deleted_at三个字段,如果数据库表中没有定义这些字段,则映射时就会报错。
因为数据库中不是所有的表都需要时间戳字段,所以全局配置 timestamps 一般都是false,在具体表的定义时可以自行配置是否开启时间戳,具体可以查看下一节内容。

  • timezone

timezone是针对时间差的配置,这里需要加上加上东八区,确保时间的准确。

  • dialectOptions

dialectOptions 是针对数据库时间戳字段的格式化输出,在数据查询时就会自动格式化成我们配置的格式。

  • pool

pool是配置连接池
如果从单个进程连接到数据库,则应仅创建一个 Sequelize 实例. Sequelize 将在初始化时设置连接池. 可以通过构造函数的 options 参数(使用options.pool)配置此连接池,如以下示例所示:
如果从多个进程连接到数据库,则必须为每个进程创建一个实例,但每个实例应具有最大连接池大小,以便遵守总的最大大小.例如,如果你希望最大连接池大小为 90 并且你有三个进程,则每个进程的 Sequelize 实例的最大连接池大小应为 30.

表的定义

egg项目中,一个数据表对应的是一个 app/model 目录下的一个文件,先运行创建数据库表的脚本,关于sql脚本请自行查询sql语法

1
2
3
4
5
6
7
CREATE TABLE `student` (
`id` int NOT NULL AUTO_INCREMENT COMMENT '学生ID: 主键 + 自增',
`number` varchar(64) NOT NULL COMMENT '学号: 非空',
`password` varchar(11) NOT NULL COMMENT '密码: 非空',
`class_id` int(11) DEFAULT NULL COMMENT '课程ID: 课程表外键',
PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

在app/model目录下声明映射文件:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
// app/modal/student.js

module.exports = app => {
const { STRING, INTEGER } = app.Sequelize;

const Student = app.model.define('student', {
id: {
type: INTEGER,
autoIncrement: true,
primaryKey: true,
comment: '学生ID: 主键 + 自增',
},
number: {
type: STRING(11),
allowNull: false,
comment: '学号: 非空',
},
password: {
type: STRING(32),
allowNull: false,
comment: '密码: 非空',
},
classId: {
type: INTEGER(11),
foreignKey: true,
comment: '课程ID: 课程表外键',
}
});
return Student;
}

映射数据表字段定义时,mysql数据类型与Sequelize对应如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
Sequelize.STRING                      // VARCHAR(255)
Sequelize.STRING(1234) // VARCHAR(1234)
Sequelize.STRING.BINARY // VARCHAR BINARY
Sequelize.TEXT // TEXT
Sequelize.TEXT('tiny') // TINYTEXT

Sequelize.INTEGER // INTEGER
Sequelize.BIGINT // BIGINT
Sequelize.BIGINT(11) // BIGINT(11)

Sequelize.FLOAT // FLOAT
Sequelize.FLOAT(11) // FLOAT(11)
Sequelize.FLOAT(11, 12) // FLOAT(11,12)

Sequelize.DOUBLE // DOUBLE
Sequelize.DOUBLE(11) // DOUBLE(11)
Sequelize.DOUBLE(11, 12) // DOUBLE(11,12)

Sequelize.DECIMAL // DECIMAL
Sequelize.DECIMAL(10, 2) // DECIMAL(10,2)

Sequelize.DATE // DATETIME 针对 mysql / sqlite, TIMESTAMP WITH TIME ZONE 针对 postgres
Sequelize.DATE(6) // DATETIME(6) 针对 mysql 5.6.4+. 小数秒支持多达6位精度
Sequelize.DATEONLY // DATE 不带时间.
Sequelize.BOOLEAN // TINYINT(1)

字段属性值如下:

属性名 类型 默认值 是否必填 说明
type Any 无 是 字段数据类型
primaryKey Boolean false 否 主键,一般每个数据库表都有一个主键
autoIncrement Boolean false 否 自增,可以配置自增起始值
allowNull Boolean false 否 是否允许为空
defaultValue Any 无 否 默认值,一般在时间戳上用的比较多
field String 字段名 否 自定义字段名,当名称和数据库字段不一样时(驼峰和下划线转换之后),配置字段映射
unique Any 无 否 唯一性约束

具体关于 sequelize model 的操作可以查看 文档

表的操作

Sequelize 封装了底层sql语句提供有很多api,可以很方便的操作数据库,有兴趣可以查看官方文档:Sequelize

查询

Sequelize Api有很多的查询api,用的比较多的如 findAll、findOne、findByPk 等方法,其他请查看官方文档:model-querying-basics

这里以 student 表查询为例,主要讲述实际项目中可能会踩坑的点

  • 条件查询

条件查询又称where查询,即使用 where 关键字来做条件查询,如学生信息的模糊查询:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// 模糊查询序号/姓名
Student.findAll({
where: {
[Sequelize.Op.or]: [
{
// 姓名的模糊查询
name: {
[Sequelize.Op.like]: "%" + keyword + "%"
}
},
{
// 学号的模糊查询
number: {
[Sequelize.Op.like]: "%" + keyword + "%"
}
}
]
}
});

注意网上有些案例会使用 $or 和$like 关键字,我们使用时可能会出现警告或报错,这是因为官方为了更好的安全性,强烈建议在代码中使用Sequelize.Op中的符号运算符,如Op.and/Op.or,而不依赖于任何基于同轴的运算符,如$and/$or。
如果非要使用的话,需要配置别名映射,配置方法如下:

config/config.default.js

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41

config.sequelize = {
// 使用默认运算符别名
operatorsAliases:{
$eq: Op.eq,
$ne: Op.ne,
$gte: Op.gte,
$gt: Op.gt,
$lte: Op.lte,
$lt: Op.lt,
$not: Op.not,
$in: Op.in,
$notIn: Op.notIn,
$is: Op.is,
$like: Op.like,
$notLike: Op.notLike,
$iLike: Op.iLike,
$notILike: Op.notILike,
$regexp: Op.regexp,
$notRegexp: Op.notRegexp,
$iRegexp: Op.iRegexp,
$notIRegexp: Op.notIRegexp,
$between: Op.between,
$notBetween: Op.notBetween,
$overlap: Op.overlap,
$contains: Op.contains,
$contained: Op.contained,
$adjacent: Op.adjacent,
$strictLeft: Op.strictLeft,
$strictRight: Op.strictRight,
$noExtendRight: Op.noExtendRight,
$noExtendLeft: Op.noExtendLeft,
$and: Op.and,
$or: Op.or,
$any: Op.any,
$all: Op.all,
$values: Op.values,
$col: Op.col
},
// 其他配置
}
  • 分页查询

在页面列表显示的时候,数据需要分页查询,要用到两个查询关键字:limit和offset,分别表示限制查询数量和跳过查询的数量。利用这两个关键字就可以很方便的执行分页查询

1
2
3
4
5
6
7
8
9
10
11
12
13
// 获取查询参数
const { pageIndex, pageSize } = ctx.request.query

Student.findAndCountAll({
offset: (pageIndex - 1) * pageSize, // offet 去掉前多少个数据
limit: pageSize, // limit 每页数据数量
}).then(res => {
// 查询结果
return {
data: res.rows,
total: res.count,
}
});
  • 排序查询

排序查询使用order 关键字,结合多个条件,实现顺序或倒序查询,如按id查询:

1
2
3
4
5
6
Student.findAndCountAll({
order: [
// 多添加排序,在下面新增条件即可
['id', 'DESC'], // ASC 升序 DESC 降序
]
})
  • 联表查询

相比较其他查询,联表查询会复杂一些,在查询之前需要明确标识表之间的映射关系(一对一、一对多或多对多),这里只介绍基本查询语法,详细请查看后面表的关联部分。

联表查询使用了 include 关键字,表示需要连接其他数据表来查询。

为了演示demo,我们在新建一个教师表,并修改 student 添加班主任字段:

teacher

1
2
3
4
5
6
CREATE TABLE `teacher` (
`id` int NOT NULL AUTO_INCREMENT COMMENT '教师ID: 主键 + 自增',
`number` varchar(64) NOT NULL COMMENT '教师编号: 非空',
`name` varchar(11) NOT NULL COMMENT '教师姓名: 非空',
PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

修改学生表,新增班主任ID(head_teacher_id)字段,关联教师表:

1
2
3
4
5
-- 修改 student,新增 head_teacher_id 字段
ALTER TABLE `student` ADD `head_teacher_id` INT NOT NULL COMMENT '班主任';

-- 设置外键关联
ALTER TABLE `student` ADD CONSTRAINT `fk_teacher_student` FOREIGN KEY (`head_teacher_id`) REFERENCES `teacher` (`id`) ;

在查询 student 信息时,同时关联查询到班主任信息,需要两个步骤:设置关联关系、联表查询数据

1.设置关联关系

设置关联关系需要修改 student 表模型,添加外键字段和声明与teacher表的关系:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
module.exports = app => {
const { INTEGER } = app.Sequelize;

const Student = app.model.define('student', {
// 1、修改表字段
headerTeacherId: {
type: INTEGER(11),
foreignKey: true,
comment: '班主任ID',
}
});

// 2、声明关联关系,一对一关系,即一个学生只有一个班主任,其他还有 一对多、多对多关系
app.model.Student.hasOne(app.model.Teacher, {
foreignKey: 'headerTeacherId', // 外键约束
as: 'headerTeacher', // 别名
});
return Student;
}

2.联表查询数据

使用 include 关键字,联表查询班主任数据:

1
2
3
4
5
6
7
8
9
Student.findByPk(id, {
include: [
// 联表查询,
{
model: model.Teacher,
as: "headerTeacher", // 注意这里的别名一定要和 model 中的别名一样
}
]
})

注意:在列表查询的时候,为了查询性能考虑,尽量不要使用联表查询,类似在js 循环中不要做过多的操作,推荐分开查询学生和老师列表,再手动组装数据。

创建/更新

sequelize针对数据的创建和更新封装了很多方法,而我们用的比较多的几个方法就是:create、bulkCreate、update等,而 bulkCreate 这个方法比较特殊,即可以用于批量创建也可以批量更新,下面我们分别查看不同场景下的使用方式

  • 创建和批量创建

sequelize中create和bulkCreate,分别是支持单条创建和批量创建,使用方式如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
// 创建单条记录
Student.create({
number,
password,
classId,
headerTeacherId,
})

// 批量创建记录
Student.bulkCreate([
{
number,
password,
classId,
headerTeacherId,
},
// 其他数据
])

当然这里针对类似学号这样的字段,一般都是按照固定格式自动生成,Sequelize也给我们提供了getter和setter 的便捷方式,类似于 Proxy的getter和setter:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
const Student = sequelize.define('student', {
// 其他操作
password: {
type: DataTypes.STRING,
get() {
// 按照指定格式返回数据,一般用于虚拟字段
const rawValue = this.getDataValue(username);
return rawValue ? rawValue.toUpperCase() : null;
},
set(value) {
// 按照预定义规则配置数据
this.setDataValue('password', hash(value));
}
},
});
  • 更新

Sequelize提供的 update 和 bulkCreate 都可以实现更新,参数稍有区别,返回值也不一样,具体可自行查阅:文档,这里值介绍bulkCreate批量更新

1
2
3
4
5
6
7
Student.bulkCreate(vualueArray,
{

// updateOnDuplicate 表示在插入的时候如果行键(主键)已存在,则更新那些字段
updateOnDuplicate: ['password', 'headerTeacherId'],
}
)

这里 bulkCreate 更新数据的方式比较奇怪,它本身执行的其实是插入操作,只是在遇到主键已存在的时候,才会更新指定的字段,使用的时候需要注意,推荐添加注详细说明,避免代码歧义,也方便维护。

而针对单条记录的更新还可以 findByPk/findOne + save 方式,这种方式其实就是先查询到某条记录,然后 set 字段值,最后调用 save 方法更新,没有什么好说的,看代码就完事:

1
2
3
4
5
6
7
8
9
10
// 1、查询数据
const student = await model.Student.findByPk(1)

if (student) {
// 2、设置字段值
student.set('password', newPassword)

// 3 更新到数据库
student.save()
}

删除/恢复

数据的删除可以调用 destroy 或 truncate(Model.destroy({ truncate: true })便捷方法),数据恢复调用restore, 这里不再多说,具体请查询:文档

注意当开启偏执表的时候,destroy 实际上是软删除操作,真实删除需要传 force 参数,具体可以查看:文档,关于偏执表请查看后面章节

表的关联

数据库中联表查询很常见,当关联多个表做查询时,一定要梳理好各个数据表之间的关联关系,文档 Sequelize Association文档,讲述的非常清楚,在我们这里只介绍基础用法。

这里我们以学生、老师、班级、课程为例,分别讲述下数据表中的 一

  • 一对一

学生和信息表对应是一对一的关系,关系定义用到 hadOne 和 belongsTo 方法, 数据 model 定义如下:

以学生表为源表,信息表为目标表

1
2
3
4
5
6
7
8
9
10
// 表的关联
Student.associate = () => {
// 以学生为源表,信息表为目标表,使用 hasOne 表示一个学生有一条信息
app.model.Student.hasOne(app.model.Info,
{
foreignKey: "infoId",
as: "info", // 别名
}
)
};

以信息表为源表,学生表为目标表

1
2
3
4
5
6
7
8
9
10
// 表的关联
Info.associate = () => {
// 以信息为源表,学生表为目标表,使用 belongsTo 表示一条信息属于一个学生
app.model.Info.belongsTo(app.model.Student,
{
foreignKey: "student_id",
as: "student", // 别名
}
)
}

查询语句如下:

查询学生表,连表查询学生信息

1
2
3
4
5
6
7
8
9
Student.findByPk(id, {
include: [
{
model: model.Info,
as: "info", // 必须和associate中的名称一样
attributes: ["name", "mobile"], // 过滤需要的属性
}
]
}

查询信息表,连表查询学生信息

1
2
3
4
5
6
7
8
9
Info.findByPk(id, {
include: [
{
model: model.Student,
as: "student", // 必须和associate中的名称一样
attributes: ["name", "mobile"], // 过滤需要的属性
}
]
}
  • 一对多

班级和学生的关系是一对多的关系,关系定义用到 hadMany 和 belongsTo 方法, 数据 model 定义如下:

以班级表为源表,学生表为目标表

1
2
3
4
5
6
7
8
9
10
// 表的关联
Class.associate = () => {
// 以班级表为源,学生表为目标,使用 hasMany 表示一个班级有多个学生
app.model.Class.hasMany(app.model.Student,
{
foreignKey: "student_id",
as: "student", // 别名
}
)
}

以学生表为源表,班级表为目标表

1
2
3
4
5
6
7
8
9
10
// 表的关联
Student.associate = () => {
// 以学生表为源表,班级表为目标表,使用 belongsTo 表示一个学生属于某个班级
app.model.Student.belongsTo(app.model.Class,
{
foreignKey: "classId",
as: "class", // 别名
}
)
};
  • 多对多

学生和课程的关系就是多对多关系, 关系定义受用 hasMany 和 belongsToMany, 通过中间表 student_lesson 关联数据, 数据 model 定义如下:

多对多关系,源数据表和目标数据表都可以使用 hasMany 和 belongsToMany 做关系映射,使用参数一样

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
// 表的关联
Student.associate = () => {
// 查询当前学生有哪些课程
app.model.Student.hasMany(app.model.Lesson,
{
through: app.model.StudentLesson, // 通过中间表关联查询
foreignKey: "student_id", // StudentLesson 对 Student 表的外键
otherKey: 'lesson_id', // StudentLesson 对 Lesson 表的外键,也可以不用声明,会自动匹配
as: "lessons", // 别名
}
)

// 或者

// 查询当前课程有哪些学生
app.model.Lesson.belongsToMany(app.model.Student,
{
through: app.model.StudentLesson, // 通过中间表关联查询
foreignKey: "lesson_id", // StudentLesson 对 Lesson 表的外键
otherKey: 'student_id', // StudentLesson 对 Student 表的外键,也可以不用声明,会自动匹配
as: "students", // 别名
}
)
}

这里需要注意的是,在关联数据表查询时,需要明确源表和目标表的关系是一对一、一对多还是多对多,在 associate 方法中正确声明关联方式,确保查询结果正常

偏执表

对于需要删除的数据,一般不会深处真实数据,而是使用软删除,即用一个状态值来表示是否删除该条记录,从而保留数据库数据。

在 Sequelize 中删除数据使用了字段 deletedAt 来表示数据是否被删除,当然使用这个字段需要 Sequelize 同时开启 timestamps 和 paranoid 配置项,表示会启用时间戳和软删除,这时自动插入 createdAt、updatedAt 和 deletedAt 这个时间戳字段。

在创建数据表时的配置如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39

module.exports = app => {
const { INTEGER, DATE, NOW } = app.Sequelize;

const Student = app.model.define('student', {
id: {
type: INTEGER,
autoIncrement: true,
primaryKey: true,
comment: '学生ID: 主键 + 自增',
},
// 其他
gmtCreate: {
type: DATE,
default: NOW,
comment: "创建时间"
},
gmtModified: {
type: DATE,
comment: "修改时间"
},
gmtDelete: {
type: DATE,
comment: "删除标识",
description: '当值非空时,则表示被删除'
}
},
{
paranoid: true, // 偏执表,用于软删除
timestamps: true, // 启用时间戳

// 重命名时间戳字段
createdAt: "gmtCreate",
updatedAt: "gmtModified",
deletedAt: "gmtDelete"
}
);
return Student;
};

事务处理

在数据库中,事务是指一个最小的不可再分的工作但愿,通常一个事务对应一个完整的业务(例如银行账户转账业务,该业务就是一个最小的工作单元)

事务的四大特征(ACID):

  1. 原子性(A):事务只最小单元,不可再分

  2. 一致性(C):事务要求所有的DML语句操作的时候,必须保证同时成功或者失败

  3. 隔离性(I):事务A和事务B之间具有隔离性

  4. 持久性(D):持久性是事务的保证,事务终结的标志

事务有很多专业术语,如开启事务、事务结束、提交事务、回滚事务等,而与事务相关的两条重要的 Sequelize 方法是:commit(提交)和 rollback(回滚)

例如事务处理场景:

新入职一个老师,需要为其分配教授班级和课程,这是一个完整的业务逻辑,需要使用事务确保完整性,在 Sequelize 中对业务处理流程如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
let transaction;
try {
// 创建事务
transaction = await model.transaction();
// 处理业务流程

// 步骤一:新增教师记录
const { dataValues: teacher } = await model.Teacher.create(rest, {
transaction
});

// 步骤二:新增教授的课程列表:毛概、历史等课程
await model.Lesson.bulkCreate(
lessons.map(lesson => ({ ...lesson, teacherId: teacher.id })),
{
transaction
}
);

// 步骤三:新增教授的班级
await model.Class.create(
{ ...class, teacherId: teacher.id },
{ transaction }
);

// 事物提交
await transaction.commit();
return project;
} catch (error) {
// 异常:事务回滚
await transaction.rollback();
throw error;
}

注意对数据库中的复杂业务处理必须使用事务,确保数据流程正确

总结

Node ORM Sequelize 对数据库的操作封装了很多便捷方法,在使用时可以参考本篇文档,避免踩坑,当然如果文档中的理解或使用方法有问题,欢迎指正。

参考文档

Docker 如何部署 Node 应用

图片来源:https://blog.papercut.com/wp-content/uploads/2019/02/docker-logo-1024x597.png

[TOC]

前言

正文

  • Dockerfile
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
# node镜像
FROM node:12.18.3

# 这个是容器中的文件目录
RUN mkdir -p /home/admin/doc-node

# 设置工作目录
WORKDIR /home/admin/doc-node

# 拷贝package.json文件到工作目录
# !!重要:package.json需要单独添加。
# Docker在构建镜像的时候,是一层一层构建的,仅当这一层有变化时,重新构建对应的层。
# 如果package.json和源代码一起添加到镜像,则每次修改源码都需要重新安装npm模块,这样没有必要。
# 所以,正确的顺序是:
# 添加package.json;
# 安装npm模块;
# 添加源代码。
COPY package.json /home/admin/doc-node/package.json

# 安装npm依赖(使用淘宝的镜像源)
# 如果使用的境外服务器,无需使用淘宝的镜像源,即改为`RUN npm i`。
RUN npm i --production --registry=https://registry.npm.taobao.org

# 拷贝所有源代码到工作目
COPY ./dist /home/admin/doc-node/

# 暴露容器端口
EXPOSE 9423

CMD npm run test
  • 构建镜像
1
docker build -t doc-node .

构建结果如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
➜  doc-node git:(master) ✗ docker build -t doc-node .    
Sending build context to Docker daemon 546.6MB
Step 1/8 : FROM node:12.18.3-alpine
---> 18f4bc975732
Step 2/8 : RUN mkdir -p /home/admin/doc-node
---> Using cache
---> 4c02163f06fd
Step 3/8 : WORKDIR /home/admin/doc-node
---> Using cache
---> c5028665498d
Step 4/8 : COPY package.json /home/admin/doc-node/package.json
---> e5234ca8c018
Step 5/8 : RUN npm i --production --registry=https://registry.npm.taobao.org
---> Running in 2c0158284144
Removing intermediate container 2c0158284144
---> 1b1c86bca5a9
Step 6/8 : COPY ./dist /home/admin/doc-node/
---> 4fb32124c0dc
Step 7/8 : EXPOSE 9423
---> Running in 7090c27bd6c1
Removing intermediate container 7090c27bd6c1
---> 2a8df7c21c1a
Step 8/8 : CMD npm run test
---> Running in 52b38538ff92
Removing intermediate container 52b38538ff92
---> 9e045ca76af7
Successfully built 9e045ca76af7
Successfully tagged doc-node:latest
  • 运行容器

查看构建的镜像

1
docker images

结果:

使用构建的进行,实例一个容器:

1
docker run --name docNode -p 9423:9423 -d 9e045ca76af7

运行完毕就可以看到容器实例

  • 提交镜像

镜像构建完毕后,可以提交到docker hub上,官网地址:https://hub.docker.com/

提前前需要打一个tag

1
docker tag 6f744b5d6dad zhaowei666/doc-node:v1.0

之后提交镜像

1
docker push zhaowei666/doc-node:v1.0

当出现下面打印时,则表示上传成功

1
2
3
4
5
6
7
8
9
10
The push refers to repository [docker.io/zhaowei666/doc-node]
696f9fe6abcf: Pushed
15bb3400b366: Pushed
7ebf5d8bef67: Pushed
d3eefd1127e9: Pushed
aedafbecb0b3: Mounted from library/node
db809908a198: Mounted from library/node
1b235e8e7bda: Mounted from library/node
3e207b409db3: Mounted from library/node
v1.0: digest: sha256:a18d7b8d4ccd1dbd4fcd0a6f3c2854e7dd0e9480af6c3e679778b2808164f20b size: 1993
  • 下载镜像

镜像上传之后,部署到其他环境时,查询并下载镜像运行容器即可

下载镜像

1
docker pull zhaowei666/doc-node:v1.0

Js进程线程和多进程多线程通信

[TOC]

线程与进程

进程(Process)

进程是一个具有一定独立功能的程序在一个数据集上的一次动态执行的过程,是操作系统进行资源分配和调度的一个独立单位,是应用程序运行的载体。

进程是一种抽象的概念,从来没有统一的标准定义。
进程一般由程序、数据集合和进程控制块三部分组成:

  • 程序用于描述进程要完成的功能,是控制进程执行的指令集;
  • 数据集合是程序在执行时所需要的数据和工作区;
  • 程序控制块(Program Control Block,简称PCB),包含进程的描述信息和控制信息,是进程存在的唯一标志。

在某一时刻,一个 CPU 中只能运行一个进程,它是在各个进程之间来回切换的,每个进程执行的速度也不确定。

线程(Thread)

线程是程序执行中一个单一的顺序控制流程,是程序执行流的最小单元,是处理器调度和分派的基本单位。

线程的运行状态:

进程与线程的区别与联系

  1. 线程是程序执行的最小单位,而进程是操作系统分配资源的最小单位;
  2. 一个进程由一个或多个线程组成,线程是一个进程中代码的不同执行路线;
  3. 进程之间相互独立,但同一进程下的各个线程之间共享程序的内存空间(包括代码段、数据集、堆等)及一些进程级的资源(如打开文件和信号),某进程内的线程在其它进程不可见;
  4. 调度和切换:线程上下文切换比进程上下文切换要快得多。

线程与进程关系的示意图:

111

扩展:关于 cpu 进程调度算法

JavaScript中的线程与进程

众所周知,javascript是单线程的,这是由于在早期js作为脚本语言只是用来辅助优化用户交互的,并没有赋予多线程能力。

针对现在的js的线程和进程处理能力,主要区分为浏览器环境和node环境

浏览器

浏览器是多进程的,系统给每个进程分配了资源(CPU、内存等),每打开一个Tab页,就相当于创建了一个独立的浏览器进程。

浏览器主要包含了下面这个进程:

  • Browser进程:浏览器的主进程,有且只有一个,负责协调和主控,只要有以下作用

    • 负责浏览器界面显示,与用户交互,如前进、后退等
    • 负责各个页面的管理、创建和销毁其他进程
    • 将Renderer进程得到的内存中的Bitmap,绘制到用户界面上
    • 网络资源的管理、下载等
  • Renderer进程(浏览器渲染进程,浏览器内核,内部是多线程的):默认每一个Tab页面都是一个进程,互不影响。主要作用是 页面渲染、脚本执行、事件处理等

  • GPU进程:最多只有一个,用户3D绘制等

  • 第三方插件进程:每种类型的插件对应一个进程,仅当使用该插件时才创建

浏览器多进程的优势

相比较与单进程浏览器,多进程有如下优势:

  • 避免单个Page Crash影响到整个浏览器
  • 避免第三方插件Crash于影响到整个浏览器
  • 多进程充分利用多核优势
  • 方便使用沙盒模型隔离插件等进程,提高浏览器的稳定性

渲染进程

对于前端开发人员来说,接触到最多的可能就是浏览器的渲染进程,渲染进程内部是多线程的,主要包括以下几个线程:

  1. GUI渲染线程
  • 负责渲染浏览器界面,解析HTML、CSS、构建DOM树和RenderObject树,布局和绘制等
  • 当界面需要重绘(Repaint)或由于某种操作引发回流(Reflow)时,改建成就绘制执行
  • 注意:GUI渲染线程和JS引擎线程是互斥的,当JS引擎执行时GUI线程绘被挂起(相当于被冻结),GUI更新会被保存在一个队列中等JS引擎空闲时立即被执行
  1. JS引擎线程
  • JS引擎线程也被成为JS内核,负责处理JavaScript脚本程序,如V8引擎
  • JS引擎线程负责解析JavaScript脚本,运行代码
  • JS引擎一直等待着任务队列中任务的到来,然后加以处理,一个Tab页(Renderer进程)中无论什么时候只有一个JS线程在执行JS程序
  • 同样注意,GUI渲染线程与JS引擎线程是互斥的,所以如果JS执行的时间过长,这样就会造成页面的渲染不连贯,导致页面渲染加载阻塞。
  1. 事件触发线程
  • 归属于浏览器而不是JS引擎,用来控制事件循环
  • 当JS引擎执行代码块如setTimeout时(也可来自浏览器内核的其他线程,如鼠标点击、Ajax异步请求等),会将对应的任务添加到事件线程中
  • 当对应的事件符合触发条件时被触发时,事件触发线程会把事件添加到等待处理队列中,等待JS引擎的处理
  • 注意:由于JS的但线程关系,所以这些待处理队列中的事件都得排队等待JS引擎处理(当JS引擎空闲时才会去执行)
  1. 定时器触发线程
  • setInterval与setTimeout所在的线程
  • 浏览器定时器并不是有JavaScript引擎计数的(因为JavaScript引擎是但线程的,如果处于阻塞线程状态就会影响计时的准确性)
  • 通过单线程来计时并触发定时器事件(计时完毕后,添加到事件对勒中,等待JS引擎空闲后执行)
  • 注意:W3C在HTML标准中规定,要求setTimeout中低于4ms的时间间隔算为4ms
  1. 异步Http请求线程
  • XMLHttpRequest在连接后,是通过浏览器新开一个线程来请求数据
  • 当监测到状态变更时,如果设置有回调函数,异步线程就产生状态变更事件,将回调放置事件队列中,再由JavaScript引擎执行

从Event Loop谈JS的运行机制

到这里我们已经知道了JS引擎是单线程的,在浏览器Event Loop中会涉及到下面几个线程概念:

  • JS引擎线程
  • 事件触发线程
  • 定时触发线程

对于JS中的其他概念如下:

  • JS分为同步任务和异步任务
  • 同步任务都在主线程上执行,形成一个执行栈
  • 主线程之外,事件触发线程管理者一个任务队列,只要异步任务有了执行结果,就在任务队列中放置一个事件
  • 一旦执行栈中的所有同步任务执行完毕(此时JS引擎空闲),系统就会读取任务队列,将可运行的异步任务添加到执行栈中,开始继续执行

JS多线程的实现

由于JS引擎是单线程的,当JS执行事件过长会阻塞页面渲染,那么真多CPU密集型的计算该如何处理呢?

针对这样的问题,在HTML5中支持了 Web Worker

在MDN的解释中,一个Worker是使用一个构造函数创建的一个对象(e.g.worker())运行一个命名的JavaScript文件,这个文件包含将在工作线程中运行的代码

workers运行在一个全局上下文中,不同于当前的window环境,所以在worker线程中,是不能通过window获取当前全局范围的数据

可以这么理解:

  • 创建Worker时,JS引擎项浏览器申请新开一个子线程(子线程是浏览器创建的,完全手祝线程控制,并且不能操作DOM)
  • JS引擎线程与worker线程间通过特定的方式通信(postMessage API,需要通过序列化对象来与线程交互特定的数据)

扩展:关于Web Worker(专有) 和 SharedWorker(共享)线程通信
https://juejin.cn/post/6844903736238669837

一个Nodejs服务的简单构成:一个进程 + 一个线程 + 一个事件循环 + 一个 JS 引擎 + 一个 Node.js 实例

Node

Node.js 是 Javascript 在服务端的运行环境,构建在 chrome 的 V8 引擎之上,基于事件驱动、非阻塞I/O模型,充分利用操作系统提供的异步 I/O 进行多任务的执行,适合于 I/O 密集型的应用场景,因为异步,程序无需阻塞等待结果返回,而是基于回调通知的机制,原本同步模式等待的时间,则可以用来处理其它任务

科普:在 Web 服务器方面,著名的 Nginx 也是采用此模式(事件驱动),避免了多线程的线程创建、线程上下文切换的开销,Nginx 采用 C 语言进行编写,主要用来做高性能的 Web 服务器,不适合做业务。

Node中的进程

nodejs中的进程Process是一个全局对象,给我们提供了进程相关信息,针对Node中的多进程模型,则是利用Node Cluster模块和 child_process模块,具体可以查看eggjs官方文档:多进程模型和进程间通讯

Node中的多进程

利用Cluster模块和 child_process模块可以实现多进程

  • 守护进程

后台运行的特殊进程,不受任何终端控制的进程。

  • 工作进程
Node中的多线程

利用worker_threads(工作线程)模块可以实现多线程

worker_threads模块提供了同时运行多个线程的能力

总结

参考文章

TS 基础系列之type和interface

图片来源:https://ss3.bdstatic.com/70cFv8Sh_Q1YnxGkpoWK1HF6hhy/it/u=1573783262,3178598711&fm=26&gp=0.jpg

[TOC]

一 前言

在ts中type和interface关键字都可用来定义数据类型,在很多开源项目中都会大量用到,那这两者到底有什么区别,使用场景有什么不同呢。下面我们仔细来探讨一下

二 正文

2.1 interface(接口)

interface表示接口,在ts中也可以用来定义数据类型,但是仅限于对象、函数、类类型

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
// 对象类型
interface User {
name: string
age: number
}

// 函数类型
interface SetUser {
(name: string, age: number): void;
}

// 类类型接口
interface ClockInterface {
currentTime: Date;
setTime(d: Date);
}

// 接口实现
class Clock implements ClockInterface {
currentTime: Date;
setTime(d: Date) {
this.currentTime = d;
}
constructor(h: number, m: number) { }
}

interface定义的类型是可以继承的,并且可以多继承

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
interface Cat {
eat: string;
}

interface Dog {
pull: string;
}

// 类型继承
interface Zoom extends Cat, Dog {
play: string;
}

const zoom: Zoom = {
eat: '疯狂吃',
pull: '疯狂拉',
play: '疯狂撸'
}

2.2 type(类型别名)

ts中type表示是类型别名,即给类型起一个新的名字。type有时候和interface非常像,但是type可以用于基本类型、联合类型、元祖以及其他任何需要手写的类型

  • 基本类型

    type可以对基本类型重命名,这里不会新建一个类型,只是创建一个新名字 IString 来引用 string类型

1
2
3
4
5
// 基本类型别名
type IString = string;

const name1: IString = '张三';
const name2: string = '李四';

type

1
2
3
4
5
6
7
8
// 对象类型
type User = {
name: string
age: number
}

// 函数类型
type SetUser = (name: string, age: number) => void;

interface

1
2
3
4
5
6
7
8
9
10
// 对象类型
interface User {
name: string
age: number
}

// 函数类型
interface SetUser {
(name: string, age: number): void;
}

声明对象或函数时,使用方式都是一样的

1
2
3
4
5
6
7
8
9
10
11
12
const user: User = {
name: '张三',
age: 24
}

let setUser: SetUser;

setUser = (name: string, age: number) => {
console.log('SetUser:', name, age)
}

setUser('10', 10);
  • 类型继承(extends)

type和interface都要支持继承(extends),并且两者都可以相互继承,也就是说type可以extend interface,interface也可以extends type,仅在语法上有区别

type

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
// 对象类型
type User = {
name: string
age: number
}

// 类型继承: 用以扩展字段
type Teacher = User & {
education: string, // 学历
}

// 声明变量
const teacher: Teacher = {
name: '张三',
age: 24,
education: '本科'
}

interface

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
// 对象类型
interface User {
name: string
age: number
}

// 类型继承 用以扩展字段
interface Teacher extends User {
education: string, // 学历
}

// 声明变量
const teacher: Teacher = {
name: '张三',
age: 24,
education: '本科'
}

相互继承

type extends interface

1
2
3
4
5
6
7
8
9
interface User {
name: string
age: number
}

// type extends interface
type Teacher = User & {
education: string, // 学历
}

interface extends type

1
2
3
4
5
6
7
8
9
type User = {
name: string
age: number
}

// interface extends type
interface Teacher extends User {
education: string, // 学历
}

2.2 不同点

  • type 可以声明几杯类型别名、联合类型、元祖等类型
  • type语句中还可以使用typeof 获取实例的类型进行赋值
  • interface 能够声明合并,而type不行

总结

参考文章

封装日常工具函数和Hooks

封装日常工具函数和Hooks

概述

封装日常使用的工具函数、React组件和Hooks,提高开发效率,避免踩坑

工具函数

过滤参不合法对象属性

清理对象参数值,过滤不合法参数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
/**
* 清理对象参数值,过滤不合法参数
* @params {object} params - 待清理的对象
* @params {array} filters - 清理的值信息,默认当值为[null, undefined, NaN, '']中的任意值时,该字段被清理掉
* @returns {object} 清理之后的对象
*/
export default function clearObject(
params,
filters = [null, undefined, NaN, '']
) {
if (params instanceof Object) {
const newParams = {}
Object.keys(params).forEach(key => {
if (!filters.includes(params[key])) {
newParams[key] = params[key]
}
})
return newParams
}
return params
}

时间格式化

格式化时间戳,支持格式化时间区间

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
/**
* 时间格式化
* @params {number} start - 开始时间戳,毫秒级
* @params {number} end - 结束时间戳,毫秒级
* @params {object} config - 格式化配置项
* @param {string} format - 转换格式,默认格式是YYYY-MM-DD HH:mm
* @param {string} separator - 分割字符串,默认是'-'
* @returns {string}
*
* @example
* fixDateRequestParams(1554790648037) ==> 2019-04-09 00:00
*
* @example
* fixDateRequestParams(1554790648037, 1554790648037) ==> 2019-04-09 00:00 - 2019-04-09 00:00
*
* @example
* fixDateRequestParams(1554790648037, 1554790648037, format = 'YYYY-MM-DD') ==> 2019-04 - 09-2019-04-09
*
* @example
* fixDateRequestParams(1554790648037, 1554790648037, format = 'YYYY-MM-DD', separator = '/' ) ==> 2019-0409/2019-04-09
*/
export default function formatDate (
start,
end,
format = 'YYYY-MM-DD HH:mm',
separator = '-'
) {
if ((start && !isNaN(start)) && (end && !isNaN(end))) {
const startTime = moment(start).format(format)
const endTime = moment(end).format(format)
return `${startTime} ${separator} ${endTime}`
}

if (start && !isNaN(start)) {
return moment(start).format(format)
}

if (end && !isNaN(end)) {
return moment(end).format(format)
}

return ''
}

时间区间格式化

格式化时间为开始时间:00:00:00 - 结束时间: 23:59:59

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import moment from 'moment';
/**
* 时间区间格式化
* @param {number} date - 时间戳(毫秒级)
* @returns {object}
* start 日起开始时间: YYYY-MM-DD 00:00:00
* end 日起结束时间: YYYY-MM-DD 23:59:59
*
* @example
* formatDateSpace(1554790648037)
* ==>
* {
* start: '2019-04-09 00:00:00',
* start: '2019-04-09 23:59:59'
* }
*/
export default function formatDateSpace(date) {
if (date && !isNaN(date)) {
return {
start: `${moment(date).format('YYYY-MM-DD')} 00:00:00`,
end: `${moment(date).format('YYYY-MM-DD')} 23:59:59`
}
}
return {}
}

匹配枚举字段值

匹配枚举字段值,针对Table列表格式化显示的辅助工具函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
/**
* 匹配枚举字段值
* @param {number} key - 某状态/类型对应的type值
* @param {array} source - 所有状态/类型
* @param {string} keyName - 匹配key字段名,默认是'label'
* @param {string} valueName - 匹配value字段名,默认是'value'
* @return {string} - 该key值对应的状态/类型,匹配失败'-'
*
* @example
* const source = [
* {
* label: 1
* value:'例子1'
* },{
* label: 2
* value:'例子2'
* },
* ]
* matchRelevantValue(1, source) === '例子1'
*/
export default function formatMatchValue(key, source = [], keyName = 'label', valueName = 'value') {
const item = source.find(item => item[`${keyName}`] === key)
if (item) {
return item[`${valueName}`] || '-'
} else {
return '-'
}
}

数字格式化为千分位

数字格式化为千分位,主要格式化金额

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
/**
* 数字格式化为千分位
* @param {number} targetNumber - 数值
* @param {number} fractionDigits - 保留小数位数
* @returns {*}
* @example
* formatThousandsSeparator(1000) === 1,000
* @example
* formatThousandsSeparator(1000,2) === 1,000.00
*/
export default function formatThousandsSeparator(targetNumber, fractionDigits) {
if (!targetNumber && targetNumber !== 0) {
return '';
}

if (targetNumber === 0) {
return 0;
}

let minus = false;
/**
* 兼容负数
*/
if (targetNumber < 0) {
minus = true;
targetNumber = Math.abs(targetNumber);
}
fractionDigits = fractionDigits >= 0 && fractionDigits <= 20 ? fractionDigits : 2;
/**
* replace(/[^\d\.-]/g, '')
* 匹配 除数字、逗号(,)、短横线( - 负数符号)之外的字符串,替换成''
* eq: 'a123'.replace(/[^\d\.-]/g, '') === 123
* eq: 'a123bc'.replace(/[^\d\.-]/g, '0') === 012300
* eq: 'a123-'.replace(/[^\d\.-]/g, '0') === 0123-
*/
targetNumber = `${parseFloat((`${targetNumber}`).replace(/[^\d\.-]/g, '')).toFixed(fractionDigits)}`;
const reversedSplitNumber = targetNumber.split('.')[0].split('').reverse();
// 小数位
const decimalPlace = targetNumber.split('.')[1];
let reversedString = '';
for (let i = 0; i < reversedSplitNumber.length; i += 1) {
reversedString += reversedSplitNumber[i] + ((i + 1) % 3 === 0 && (i + 1) !== reversedSplitNumber.length ? ',' : '');
}
/**
* 兼容负数和整数
*/
return `${minus ? '-' : ''}${reversedString.split('').reverse().join('')}${decimalPlace ? `.${decimalPlace}` : ''}`;
}

金额格式化转换

金额格式化转换,针对分转元,元转分的,这里使用了 number-precision 工具包,用于金额的精准计算,避免在小数值计算时产生误差(避免踩坑)

1
npm install number-precision --save
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
import NP from 'number-precision'
import formatThousandsSeparator from './formatThousandsSeparator'
/**
* 金额格式化转换
* 元转分
* 分转元(默认千分位格式化,并保留2位小数)
* @param {number} money - 金额(元/分)
* @param {string} mode - 模式:'toYuan'(分->元)'toCent'(元->分),默认是 'toYuan'
* @params {object} config 转换配置项
* @param {boolean} thousandsSeparator - 是否需要格式化成千分位,默认为true
* @param {number} fractionDigits - 保留小数位数,默认为2
* @param {string} illegalCharacter - 非法数据是展示的字符
*
* @returns {*} 转换之后的金额
*
* @example
* formatCentToYuan(100000) === 1,000.00
*/
export default function formatMoney(money, mode = 'toYuan', config = {}) {
const { thousandsSeparator = true, fractionDigits = 2, illegalCharacter = '-'} = config

if (!money || isNaN(money)) {
return illegalCharacter
}

switch (mode) {
case 'toYuan': {
const yuan = NP.round(NP.divide(money, 100), fractionDigits)
if (!thousandsSeparator) {
return yuan
}
return formatThousandsSeparator(yuan, fractionDigits)
}
case 'toCent': {
return NP.round(NP.times(money, 100), 0)
}
default:
return illegalCharacter
}
}

工具包地址:https://github.com/zhaowei-plus/utils-tools

组件

列表搜索组件

List表头搜索组件,一般是和Antd Table配合使用,这里使用了Formily表单库,在使用前需要安装依赖

1
2
npm install --save @formily/antd
npm install --save @formily/antd-components /*扩展库*/

Formily官网地址:https://formilyjs.org/#/bdCRC5/dzUZU8il

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
import React from 'react'
import {
SchemaForm,
FormButtonGroup,
Submit,
Reset
} from '@formily/antd'

import {
formatPlaceholder,
clearObject
} from '../Utils'

import './index.less'

/**
* 格式化schema中的placeholder提示信息
*/
export const formatPlaceholder = (schema) => {
Object.keys(schema).forEach(key => {
if (schema[key].type === 'string') {
const item = schema[key]
if (!Reflect.has(item, 'x-props')) {
item['x-props'] = {}
}

if (Array.isArray(item.enum)) {
item['x-props'].placeholder = '请选择'
} else {
item['x-props'].placeholder = '请输入'
}
}
})
return schema
}

export default (props) => {
const {schema, onSearch, ...rest} = props

const onSubmit = (params) => {
// clearObject 过滤空值的属性
onSearch(clearObject(params))
}

return (
<SchemaForm
schema={{
type: 'object',
properties: formatPlaceholder(schema)
}}
onSubmit={onSubmit}
onReset={onSubmit}
className="search"
{...rest}
>
<FormButtonGroup className="search__actions">
<Submit>查询</Submit>
<Reset>重置</Reset>
</FormButtonGroup>
</SchemaForm>
)
}

css 样式如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
.search {
display: flex;
flex-wrap: wrap;
justify-content: flex-start;

.ant-form-item {
display: grid;
grid-template-columns: minmax(80px, max-content) auto;
margin-bottom: 0;

&:before {
display: none;
}

.ant-form-item-label {
height: 40px;
line-height: 40px;
padding: 0 10px;
}

.ant-form-item-control-wrapper {
height: 40px;
line-height: 40px;

.ant-calendar-picker,
.ant-select {
width: 100%;
min-width: 200px;
}
}
}

&__actions {
flex: 1;
height: 40px;
display: flex;
justify-content: flex-end;

.button-group {
height: 40px;
line-height: 40px;
width: 140px;
}
}
}

注意Search组件中的schema是Formily的标准schema(Formily Form Schema文档地址)去掉了外部的 properties 配置:
1
2
3
4
5
6
{
"type": "object",
"properties": {
...schema // 导入的schema配置
}
}

案例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
() => {
const schema = {
orgName: {
type: 'string',
title: '企业名称/编码'
}

const onSearch = (params) => {
// 根据条件搜索数据
}

return (
<Search
schema={schema}
onSearch={onSearch}
/>
)
}

显示结果:

Hooks

useList

useList hook是组装了表头搜索组件和Table结果数据的hook,通过url和默认参数搜索结果,获取Table数据并显示,具体代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
import { useState } from 'react'

/**
* useList hook,用于Table、有搜索栏的Table数据搜索
*
* @param {string} url 请求地址
* @param {object} initialParams 初始化参数,初始化时需要有搜索参数,并且在后续搜索中可以被修改的参数
* @param {object} staticParams 静态参数,每次搜索都固定不变的参数
* */
export default (url, initialParams = {}, staticParams = {}) => {
const [params, setParams] = useState(initialParams)
const [dataSource, setDataSource] = useState([])

const [pagination, setPagination] = useState({
current: 1,
pageSize: 10,
total: 0,
showQuickJumper: true,
showTotal: total => `共${total}条`
})

/*
* 查询列表信息:
* 1 刷新时,分页器不变,搜索参数不变
* 2 查询时,分页器清零,搜索参数改变
* */
const onFetch = (_pagination = pagination, _params = params) => {
const { current: currentPage, pageSize } = _pagination

const data = {
pageIndex: currentPage,
pageNo: currentPage,
pageSize,
..._params,
...staticParams
}


/**
* 向后端发送请求列表数据的方法根据项目实际自定义实现,主要
* 是针对不同项目请求方式的不同做兼容处理

* 注意:这里的请求没有写死,主要是因为很多项目中的请求方式不一样,使用时可以拷贝自行替换
* */
http.get(url, {
pageIndex: currentPage,
pageNo: currentPage,
pageSize,
..._params,
...staticParams
}).then((res) => {
const { rows = [], total } = res.data || {}
setDataSource(rows)
setParams(_params)
setPagination({
..._pagination,
total,
current: currentPage
})
})
}

/**
* 参数查询列表信息
* */
const onSearch = (_params) => {
onFetch({ ...pagination, current: 1}, _params)
}

/**
* 分页查询列表信息
* */
const onChange = (_pagination) => {
onFetch(_pagination)
}

return {
params,
onSearch,
onFetch,
// table所需要的值
table: {
pagination,
dataSource,
onChange,
},
}
}

案例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
() => {
const list = useList('serviceOrder/list')

const onSearch = (params) => {
list.onSearch(params)
}

useEffect(() => {
list.onFetch() // 搜索数据
}, [])

// 有时候需要列表搜索的参数,可以取值 list.params

const columns = [/** Table列表项 **/]

return (
<Table
columns={columns}
{...list.table}
/>
)
}

useTable

useTable 是基于useList 的简单封装,返回Table数据和XmTable组件,不需要导入Antd的Table,代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import React from 'react'
import { Table} from 'antd'

import useList from './use-list'

export default (url, initialParams = {}, staticParams = {}) => {
const list = useList(url, initialParams, staticParams)

const XmTable = (props) => {
const { rowKey = 'id', columns = [], ...rest } = props

return (
<Table
rowKey={rowKey}
columns={columns}
{...list.table}
{...rest}
/>
)
}

return {
table: list,
XmTable
}
}

案例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
() => {
const { table, XmTable } = useTable('serviceOrder/list')

const onSearch = (params) => {
table.onSearch(params)
}

useEffect(() => {
table.onFetch() // 搜索数据
}, [])

// 有时候需要列表搜索的参数,可以取值 table.params

const columns = [/** Table列表项 **/]

return (
<XmTable
columns={columns}
/>
)
}

useSearchTable
useSearchTable 是基于封装了Search组件和useTablehook,返回Table数据和SearchTable组件,代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
import React, {useState, Fragment, useEffect} from 'react'

import useTable from './use-table'
import Search from "../Search"

export default (url, initialParams = {}, staticParams = {}) => {
const [ initialValues, setInitialValues ] = useState(initialParams)
const { table, XmTable } = useTable(url, initialParams, staticParams)

const SearchTable = (props) => {
const { schema, columns = [], onSearch, ...rest } = props

const handleSearch = (params = initialParams) => {
setInitialValues(params)
table.onSearch(typeof onSearch === 'function' ? onSearch(params) : params)
}

return (
<Fragment>
<div className="app-page__card">
<Search
schema={schema}
onSearch={handleSearch}
initialValues={initialValues}
/>
</div>
<div className="app-page__card">
<XmTable
columns={columns}
{...rest}
/>
</div>
</Fragment>
)
}

useEffect(() => {
table.onSearch(initialParams)
}, [])

return {
table,
SearchTable,
}
}

案例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
() => {
const { table, SearchTable } = useSearchTable('serviceOrder/list')

// 有时候需要列表搜索的参数,可以取值 table.params

const schema = { /** Search搜索项 **/ }
const columns = [/** Table列表项 **/]

return (
<SearchTable
schema={schema}
columns={columns}
/>
)
}

useVisible
useVisible 是对Antd Modal封装的hook,可以更方便的open/close,代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import { useState, useCallback } from 'react'
/**
* 自定义 hook:用于弹出框的打开与关闭控制
*
* @param {boolean} initVisible 初始化modal的显示状态
*/
export default (initVisible = false) => {
const [params, setParams] = useState()
const [visible, setVisible] = useState(initVisible)

const open = useCallback((_params) => {
setParams(_params)
setVisible(true)
}, [])

const close = useCallback(() => {
setParams()
setVisible(false)
}, [])

return {
params,
visible,
open,
close,
}
}

案例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
() => {
const editModal = useVisible()

const opem = (orderId) => {
// open 传递的参数
editModal.open(orderId)
}

return (
{
editModal.visible && (
<EditModal
orderId={editModal.params}
onCancel={editModal.close}
onOk={() => {
editModal.close()
table.onFetch()
}}
/>
)
}
)
}

Hooks包地址:https://github.com/zhaowei-plus/utils-hooks

其他

更多自定义Hooks可以查看umijs Hooks封装

Formily入门和使用

by zhaowei 2019/12/19

[TOC]

概述

Formily是面向中后台复杂业务场景的高性能表单解决方案,具有强大的JSON Schema数据驱动的动态表单渲染能力,解决动态渲染表单场景,支持各种复杂联动、复杂校验等业务逻辑。

解决方案

Formily是Uform更名而来,所以多数基础案例可以查看Ufrom1.x版本的官网链接,里面有很多详细的使用案例。

https://uform-next.netlify.com (1.x),该版本中包含大量Formily使用案例,可以快速参考

https://formilyjs.org/#/bdCRC5/BlUJUaiw,新版本的地址,Formily的使用方法改变不大,新增加了更多的说明文档和扩展案例,对新增加的功能有更详细的说明。

表单定义

Formily具有强大的Schema解析能力,对于表单定义有Jsx描述、Json Schema描述方式,目前这两种方式不能混用

Jsx定义表单

Jsx描述是依赖Field组件用于定义表单项信息,当表单项比较多时,代码会比较多。

Field形式如下:

1
2
3
4
5
6
7
8
9
10
<SchemaForm>
<Field type="Object" name="aaa">
<Field type="string" name="bbb"/>
<Field type="array" name="ccc">
<Field type="object">
<Field type="string" name="ddd"/>
</Field>
</Field>
</Field>
</SchemaForm>

具体可以参考官方案例:Formily 简单场景

Schema定义表单

Schema定义表单是通过标准Json Schema描述表单信息,并传递给 SchameForm组件绘制出表单内容,当表单项比较多时,可以考虑使用这种方式。

Schema形式如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
const schema = {
"type":"object",
"properties":{
"aaa":{
"type":"object",
"properties":{
"bbb":{
"type":"string"
},
"ccc":{
"type":"array",
"items":{
"type":"object",
"properties":{
"ddd":{
"type":"string"
}
}
}
}
}
}
}
}

<SchemaForm schema={schema} />

具体可参考官方案例:Formily 简单场景

使用场景

Jsx和Json Schema都可以定义表单信息,但是在使用时需要编写的代码量和后期可维护性也是需要考虑的,通常在定义表单时可以参考以下情形区分使用这两种方式:

  • 包含大量表单布局(FormGrid、FormBlock、FormCard、FormStep、FormTab等),考虑使用Jsx,主要因为在Json Schema 中描述布局信息结点没有Jsx描述清晰,说明性不强、修改不是很方便。

例如当有如下布局时,则使用Field描述:

代码示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
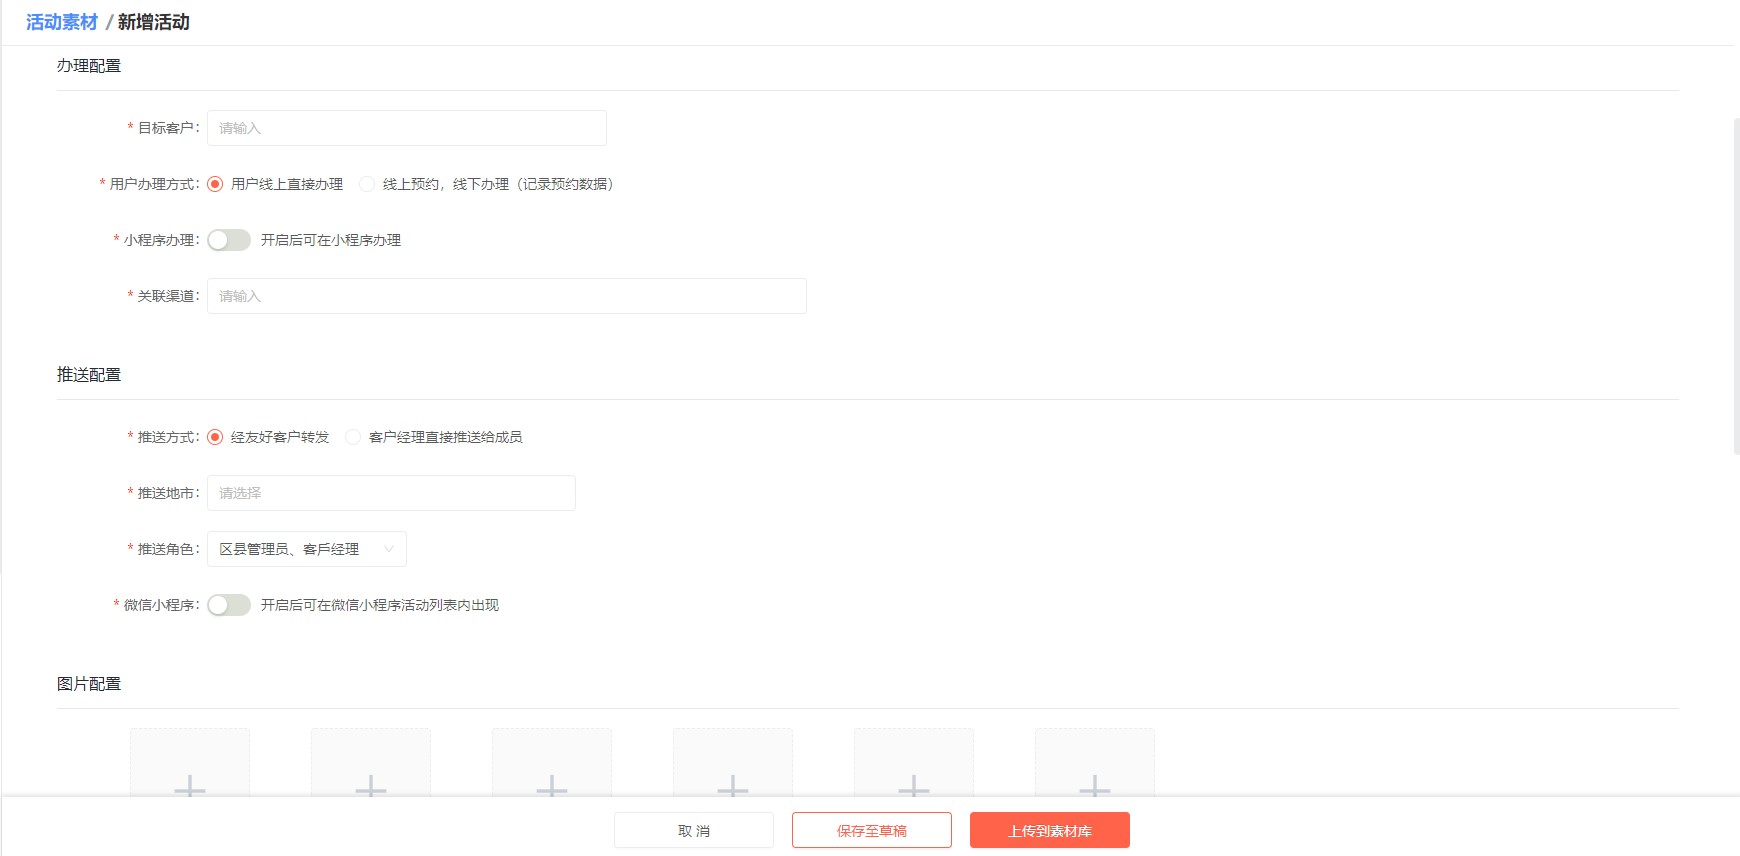
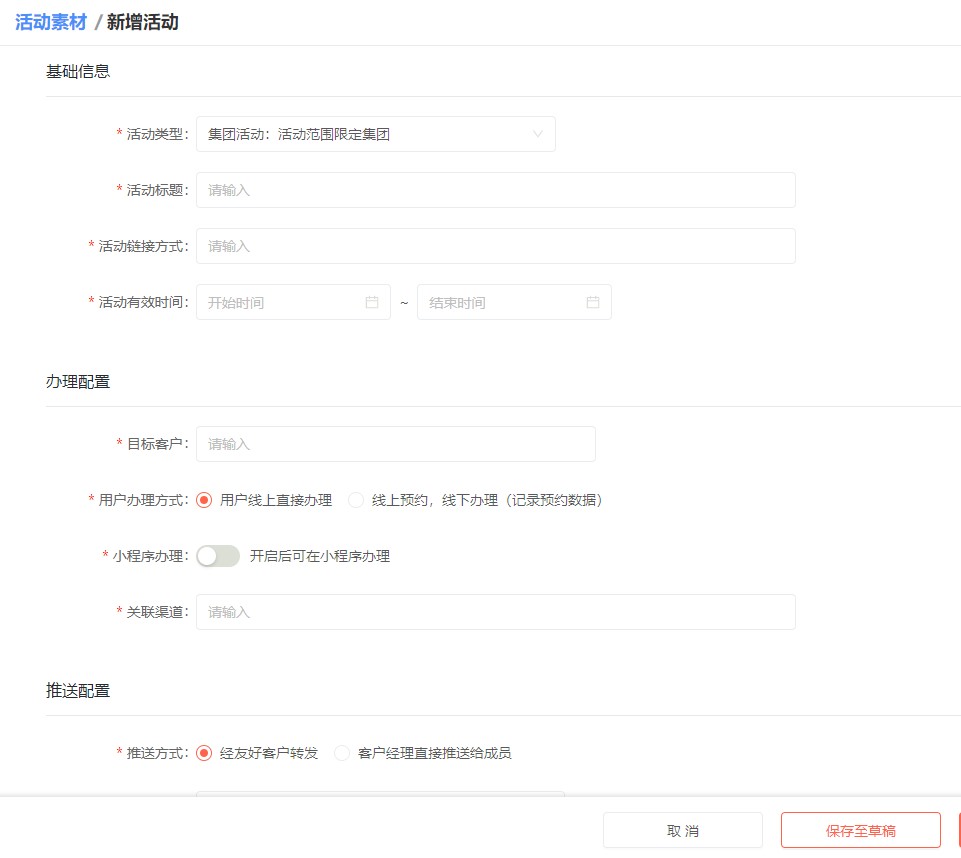
<FormBlock title="办理配置" name="handleConfig">
<Field
required={required}
editable={editable}
title="目标客户"
name="targetCustomer"
type="string"
description={useCount > 0 && `共计${useCount}人`}
enum={targetCustomerOptions}
x-props={{
placeholder: '请输入',
mode: 'multiple',
showSearch: true,
style: {width: 400},
optionFilterProp: 'label',
getPopupContainer: node => node.parentNode,
}}
/>
<Field
required={required}
editable={editable}
title="用户办理方式"
name="handleWay"
type="radio"
enum={HANDLE_METHOD}
/>
<Field
required={required}
editable={editable}
title="小程序办理"
name="apps"
type="switch-field"
x-props={{
message: '开启后可在小程序办理',
}}
/>
<Field
required={required}
editable={editable}
title="关联渠道"
name="channel"
type="string"
enum={channelOptions}
x-props={{
style: {width: 600},
placeholder: '请输入',
showSearch: true,
showArrow: false,
optionFilterProp: 'label',
getPopupContainer: node => node.parentNode,
}}
/>
</FormBlock>

  • 当表单项较多,且不含或包含较少布局信息,推荐使用Json Schema描述,简洁方便,代码量少。

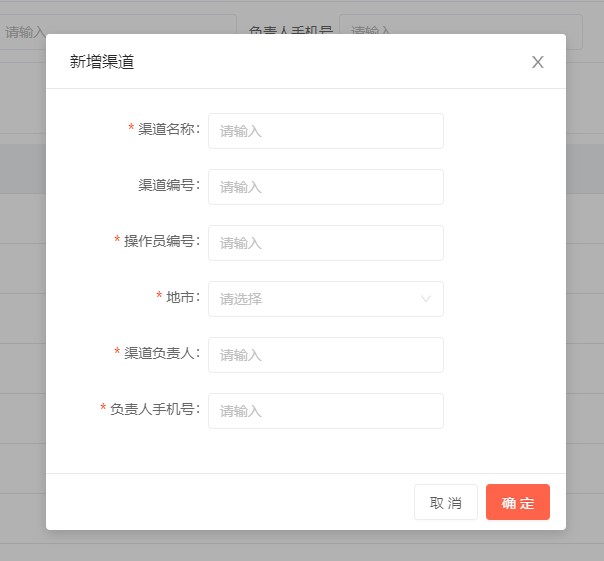
例如在弹出框中的普通表单项,就可以使用Schema描述:

代码示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
{
type: 'object',
properties: {
channelName: {
required: true,
type: 'string',
title: '渠道名称',
'x-props': {
placeholder: '请输入',
},
},
channelNumber: {
type: 'string',
title: '渠道编号',
'x-props': {
placeholder: '请输入',
},
},
operatorNumber: {
required: true,
type: 'string',
title: '操作员编号',
'x-props': {
placeholder: '请输入',
},
},
regionCode: {
required: true,
type: 'city-cascader',
title: '地市',
'x-props': {
placeholder: '请选择',
isShowProvince: true,
changeOnSelect: true,
onlyCity: true,
},
},
channelLeaderName: {
required: true,
type: 'string',
title: '渠道负责人',
'x-props': {
placeholder: '请输入',
},
},
channelLeaderMobile: {
required: true,
type: 'string',
title: '负责人手机号',
'x-props': {
placeholder: '请输入',
},
'x-rules': [
{ validator: validatorMobile }, // 这里是自定义的校验规则
],
},
}
}

数据绑定

Formily表单数据会在form内部存储表单信息,当form不是受控组件时,开发完全不用关心数据如何存放,在使用时直接获取,不需要state来存储和维护表单状态,也不用在重渲染时的进行状态逻辑判断,避免了数据保存逻辑处理,也规避组件更新时的状态判断,使用非常方便。

Formily中的数据输入有三种形式,分别是value、defauleValue、initialValues,三者的区别和使用场景可以查看官方给出的文档说明:value/defauleValue/initialValues属性使用场景

表单联动

联动处理是Formily的一大核心亮点,其强大的表单联动是依赖于它的Effects副作用处理和路径系统,处理如一对多联动、多对一联动、多依赖联动、链式联动、循环联动、联动异步、数据转换、List列表联动等复杂场景都游刃有余,性能高效且使用方便。

关于路径系统相关内容,可以查看介绍:10分钟解读UForm路径系统

关于联动处理介绍,可以查看官网介绍:Formily 实现复杂联动逻辑

联动处理

部分场景中,在表单定义初始化时,或者在运行时对部分表单项需要执行动态隐藏/显示的问题,Formily提供了两个属性visible、display用于处理这列场景,这两者的区别如下:

  • visible

当visible为false时,表单项在UI上不显示,在表单实例中数据不再输出(实际数据还是存在,只是不再对外有任何表现),在提交时,也拿不到该表单项的任何值;

  • display

当display为false时,表单项在UI上不显示,在表单实例中数据表现没有影响,在提交时,可以正常拿到该表单项的值;

使用这两个属性处理表单联动,可以解决提交过程中的字段逻辑判断过程,更方便简洁;

使用案例:visible/display的使用场景

  • x-linkages

Formily中新增加的x-linkages属性,支持配置简单的联动处理,有兴趣可以查看官网:理解表单扩展机制

  • 其他联动

Formily的联动功能非常强大,处理一对多联动、副作用校验、多依赖联、链式联动都很方便。具体请查看官网:实现复杂联动逻辑

Effects副作用处理

Formily中的effects提供强大的副作用处理能力,修改数据、数据联动和异步请求等都可以完成,在SchemaFrom组件和Field组件都有对应的effects副作用处理逻辑

  • SchemaFrom effects

SchemaFrom中副作用处理是通过effects属性传递副作用处理函数,在内部监听表单事件,对各部分内容与表单数据进行处理(表单联动、数据项的改变等),目前实际项目中的副作用也是在SchemaFrom中进行处理的,具体可以参考官方案例:Uform 联动场景(V1.0)

  • Field effects

Field中的副作用处理是通过’x-effect’属性传递副作用处理函数,内部可以调用hook,或者通过dipatch发送action,并在SchemaFrom中进行处理,目前项目中用的比较少,具体可以查看官方案例:传动门

此外,可以通过Uform Hook自定义逻辑处理,而不需要在全局Effects中做控制,具体可以查看案例:传送门

表单布局

Formily中的布局方案比较多,利用FormLayout/FormItemGrid、FormCard/FormBlock、FormSlot、FormTextBox,FormSpy、FormStep以及FormTab等都可以实现如内联布局、复杂组合布局、网格布局、分步表单、选项卡表单等复杂的表单布局,当这些方案不满足业务需求是,也可以自定义表单布局。

布局方案官方案例地址:Formily 实现复杂布局

特殊表单

  • 表单List(array,cards,table)

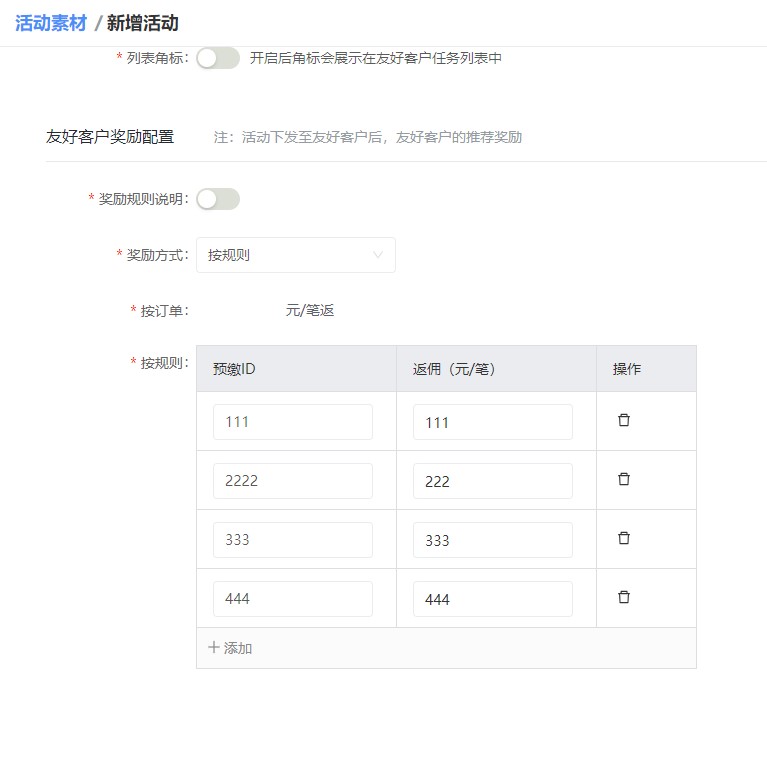
解决中后台项目中大量字段的聚合输入场景需求,如数组场景、区块型数组等场景。针对这种场景处理是一个痛点,通常是使用state/setState或React Hook操作大量数据来实现,缺少数据状态统一管理的解决方案,繁琐而且不易维护。所以在Formily中给我们提供了三种数组表单组件array、cards、table,用于管理表单list。

其解决方案可以查看下面几篇官方案例说明:
表单List、
实现递归渲染组件、
玩转自增列表组件,当实际场景非常复杂是,也可以利用Formily提供的数据管理能力实现自定义组件,可以参考官方案例:实现递归渲染组件
、实现超复杂自定义组件

项目中的应用如图:

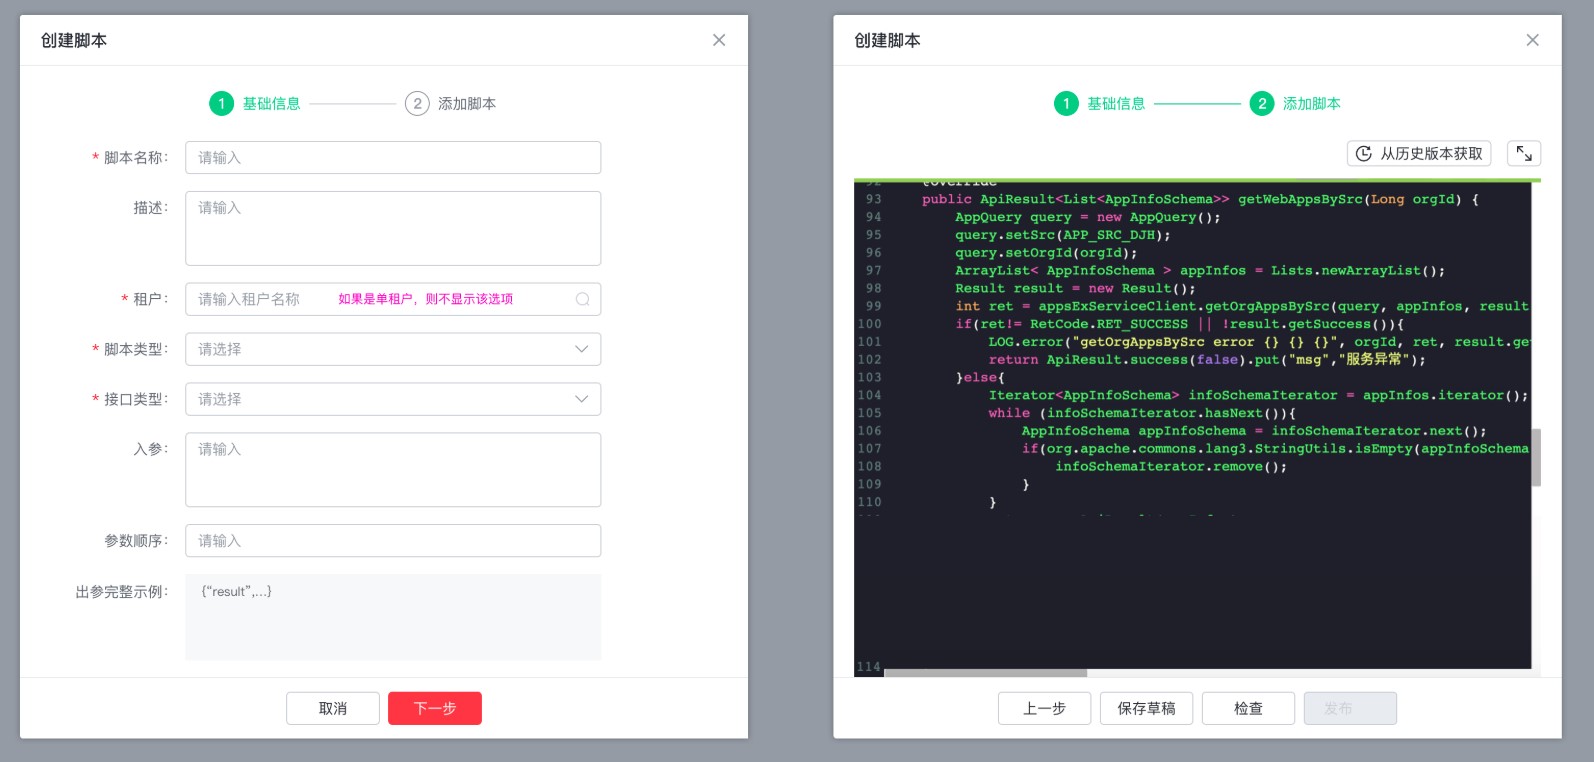
  • FormStep步骤条

FormStep即是一个表单项,也是一个表单布局组件,是将Antd Steps 步骤条和 Form 表单结合起来的一个组件。官方地址:分步表单

FormStep具有如下功能:

  1).分割表单,让每一步就像一个SchemaForm表单;

  2).状态保存,每一步的数据可以单独存储,返回时自动填充;

  3).支持Effect监听,获取表单状态信息;

  4).支持手动跳转(上一步、下一步、其他步骤);

  5).支持时间旅行;

  6).提交时的数据是全部数据集合,不需要全局存储数据;

项目中的应用如图:

  • FormSpy

FormSpy本质上是简版的Redux表单组件,用于监听组件各种事件(form、field),通过reducer对数据进行处理,并返回最终的值,也可以配合FormProvider在表单外部消费表单信息,如监听表单/表单内部字段的变化、多表单提交等。具体可以查看官方FormSpy案例说明: FormSpy

  • FormTab

FormTab是Formily新增加的整合Antd Tab选项卡表单组件,目前项目中使用的不多,具体使用请查看官方文档:选项卡表单

  • 自定义表单项

Formily中自定义需要进行表单注册,注册的表单项,只需要实现value/onChange接口即可;

表单注册有两种形式,全局注册和实例注册,全局注册的表单项会在项目全局表单中生效,实例注册的表单项只对当前SchemaForm有效;具体可以查看最新官方说明:理解表单扩展机制

表单校验

Formily的表单校验是基于完备的校验引擎,提供了如registerValidationFormats、registerValidationMTEngine等方法用于注册全局共享的校验逻辑和校验模板,具体可查看官方API文档:数据校验

  • 数据校验
    • Json Schema校验
    • validateFirst校验
    • warning校验
    • 失焦校验
  • 手工批量校验/手工清除校验消息
  • 校验规则扩展/正则规则扩展
  • 校验消息模板引擎
  • 无UI表单校验

表单提交

  • 内部提交

Formily内部提交数据,SchemFrom绑定提交方法onSubmit,内部通过Submit组件自动提交,具体可查看官方文档:表单提交

  • 外部提交

Formily外部提交数据,可以通过Api createFromActions创建actions实例,在调用actions进行提交数据,也可以通过FormProvider和FormSpy(Uform之前是ForCustomer)进行提交,具体可以参考官网文档:FormSpy

  • 多表单提交

在某些情况下,页面中有多个Form表单实例一起提交数据,在Fromily中有两种解决方案:

  • 利用createFromActions创建多个actions实例,并绑定SchemaFrom表单,提交时调用actions.submit()提交多个表单数据

  • 通过FormProvider和FormSpy,调用submit提交多表单数据(不过目前Formily提交有点问题,相信后续会解决),具体代码如下:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    export default () => {
    const onSubmit1 = params => {
    console.log("onSubmit1:", params)
    }
    const onSubmit2 = params => {
    console.log("onSubmit2:", params)
    }

    return (
    <FormProvider>
    <SchemaForm onSubmit={onSubmit1}>
    <Field name="name" title="年龄" />
    </SchemaForm>
    <SchemaForm onSubmit={onSubmit2}>
    <Field name="age" title="年龄" />
    </SchemaForm>
    <FormSpy>
    {({ form: spyForm }) => {
    const handleSubmit = () => {
    if (spyForm) {
    spyForm.submit()
    }
    }

    return (
    <Button onClick={handleSubmit} type="primary">
    保存
    </Button>
    )
    }}
    </FormSpy>
    </FormProvider>
    )
    }

表单复用(编辑/详情)

Formily在开发中提供了表单不同展示形态:编辑态和文本态,用于在不同状态下的信息展示,主要用于表单页和详情页,具体可查看官方案例:状态变换

由于Formily给我们提供了非常简单的表单定义形式,当注册自定义表单项时,可以根据props中的disabled字段,自定义实现编辑态和文本态的不同显示状态

编辑态:

文本态:

支持Hook

Formily是基于React16.8后的版本,已经全面使用hook来编写了,开发者可使用各种hook来使用Formily的特性。除了内置的生命周期,开发者还可以使用自定义Effects等一系列非常酷的特性 。(更多文档可参见Formily Hook),hooks是业务逻辑的抽象,用于简化视图的编写。

总结

Formily有强大的表单处理能力,利用Rxjs的响应式能力处理各种表单联动逻辑,可以非常方便的开发表单应用。Formily有很多实践教程,可以多多查看: 实践教程

参考文章

UForm表单解决方案 - 知乎专栏

UForm V1 要来了

UForm技术内幕

10分钟解读UForm路径系统

UForm常见问题

性能优化实践

管理业务逻辑

玩转查询列表

Rxjs学习入门

by zhaowei 2019/12/19

[TOC]

前言

​ 在学习Rxjs之前,先让我们先了解下函数式编程和响应式编程,观察者模式和迭代器模式,以及拉取 (Pull) 与推送 (Push)
协议的区别

函数式编程

函数式编程(通常简称为 FP)是指通过复合纯函数来构建软件的过程,它避免了共享的状态(share state)、易变的数据(mutable data)、以及副作用(side-effects)。

响应式编程

响应式编程(通常简称为 RP)是一种从数据流和变化出发的解决问题的模式。

观察者模式

观察者模式最常见的应用场景就是 Js Dom 事件的监听和触发
订阅:通过 addEventListener 订阅 document.body 的 click 事件
发布:当 body 节点被点击时,body 节点便会向订阅者发布这个消息

1
2
3
4
5
document.body.addEventListener('click', function listener(e) {
console.log(e);
},false);

document.body.click(); // 模拟用户点击

迭代器模式

迭代器模式可以用JavaScript 提供的Iterable Protocol可迭代协议来表示

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
var iterable = [1, 2];
var iterator = iterable[Symbol.iterator]();

var iterator = iterable();

while(true) {
try {
let result = iterator.next(); // <= 获取下一个值
} catch (err) {
handleError(err); // <= 错误处理
}

if (result.done) {
handleCompleted(); // <= 无更多值(已完成)
break;
}
doSomething(result.value);
}

主要对应三种情况:

  • 获取下一个值:调用 next 将元素一个一个返回,可支持多次调用
  • 已完成:无更多值时,next 返回元素中 done 为 true
  • 错误处理:当 next 方式执行时报错,则会抛出 error 事件,用 try catch 包裹进行错误处理

拉取 (Pull) vs. 推送 (Push)

拉取和推送是两种不同的协议,用来描述数据生产者 (Producer)如何与数据消费者 (Consumer)进行通信的。

生产者 消费者
拉取(pull) 被动的:当被调用(请求时)产生数据 主动的:决定何时请求数据
推送(push) 主动的:按照自己的节奏产生数据 被动的:对收到的数据作出反应
  • Function 是惰性的评估运算,调用时会同步地返回一个单一值。
  • Generator 是惰性的评估运算,调用时会同步地返回零到(有可能的)无限多个值。
  • Promise 是最终可能(或可能不)返回单个值的运算。
  • Observable 是惰性的评估运算,它可以从它被调用的时刻起同步或异步地返回零到(有可能的)无限多个值。

值得获取关系如下:

生产者 消费者 单值 多值
拉取(pull) 主动的:决定何时请求数据 Function Iterator
推送(push) 被动的:对收到的数据作出反应 Promise Observable

RxJS基本概念

RxJS 是 Reactive Extensions for JavaScript 的缩写,起源于 Reactive Extensions,是一个基于可观测数据流在异步编程应用中的库(可以理解为异步的lodash),是基于观察者模式和迭代器模式并以函数式编程来实现的库。

Rxjs使用Observables的响应式编程的库,可以更容易的编写异步货基于回调处理的代码,采用观察者模式、迭代器模式和函数编程思想,基于流的概念对数据进行处理

Rxjs基本概念如下:

  • Observable(可观察对象): 表示一个概念,这个概念是一个可调用的未来值或事件的集合。

  • Observer(观察者): 一个回调函数的集合,它知道如何去监听由 Observable 提供的值。

  • Subscription(订阅):表示 Observable 的执行,它主要用于取消 Observable 的执行。

  • Operator(操作): 采用函数式编程风格的纯函数,使用像 map、filter、concat、flatMap 等这样的操作符来处理集合。

  • Subject(主体): 相当于 EventEmitter,并且是将值或事件多路推送给多个 Observer 的唯一方式。

  • Schdulers(调度器):用来控制并发并且是中央集权的调度员,允许我们在发生计算时进行协调,例如 setTimeout 或 requestAnimationFrame 或其他。

Observable – 可观察对象

Observable 作为观察者,是一个值或事件的流集合,简单来说就是数据在 Observable 中流动,消费者可以使用各种 operator 对流进行处理,获取想要的结果。
observable 有三个方法:next,error,complete,分别发出不同类型的通知

创建 Observables
订阅 Observables
执行 Observables
清理 Observable 执行

Observer – 观察者

观察者是由 Observable 发送的值的消费者。
观察者只是一组回调函数的集合,每个回调函数对应一种 Observable 发送的通知类型:next、error 和 complete 。

1
2
3
4
5
var observer = {
next: x => console.log('Observer got a next value: ' + x),
error: err => console.error('Observer got an error: ' + err),
complete: () => console.log('Observer got a complete notification'),
};

​
使用观察者,需要把它提供给 Observable 的 subscribe 方法:

1
observable.subscribe(observer);

Subscription - 订阅

Subscription 是表示可清理资源的对象,通常是 Observable 的执行。Subscription 有一个重要的方法,即 unsubscribe,它不需要任何参数,只是用来清理由 Subscription 占用的资源。

1
2
3
4
5
6
var observable = Rx.Observable.interval(1000);
var subscription = observable.subscribe(x => console.log(x));
// 稍后:
// 这会取消正在进行中的 Observable 执行
// Observable 执行是通过使用观察者调用 subscribe 方法启动的
subscription.unsubscribe();

多个Subscription 还可以合在一起,这样一个 Subscription 调用 unsubscribe() 方法,可能会有多个 Subscription 取消订阅 。(涉及到多播的概念)

Operators - 操作符

操作符是 Observable 类型上的方法,比如 .map(…)、.filter(…)、.merge(…),等等。当操作符被调用时,它们不会改变已经存在的 Observable 实例。相反,它们返回一个新的 Observable ,它的 subscription 逻辑基于第一个 Observable 。
操作符是函数,它基于当前的 Observable 创建一个新的 Observable。这是一个无副作用的操作:前面的 Observable 保持不变。

  • 1、创建数据流的操作符

    • 单值:of, empty, never
    • 多值:from
    • 定时:interval, timer
    • 从事件创建:fromEvent
    • 从 Promise 创建:fromPromise
    • 自定义创建:create
  • 2、转换操作符

    • 改变数据形态:map, mapTo, pluck
    • 过滤一些值:filter, skip, first, last, take
    • 时间轴上的操作:delay, timeout, throttle, debounce, audit, bufferTime
    • 累加:reduce, scan
    • 异常处理:throw, catch, retry, finally
    • 条件执行:takeUntil, delayWhen, retryWhen, subscribeOn, ObserveOn
    • 转接:switchMap
  • 3、合并操作符

    • concat,保持原来的序列顺序连接两个数据流
    • merge,合并序列
    • race,预设条件为其中一个数据流完成
    • forkJoin,预设条件为所有数据流都完成
    • zip,取各来源数据流最后一个值合并为对象
    • combineLatest,取各来源数据流最后一个值合并为数组

可以查看用例学习先关操作符:案例

Subject – 主体

RxJS Subject 是一种特殊类型的 Observable,它允许将值多播给多个观察者,所以 Subject 是多播的,而普通的 Observables 是单播的(每个已订阅的观察者都拥有 Observable 的独立执行)。
Subject 像是 Observable,但是可以多播给多个观察者。Subject 还像是 EventEmitters,维护着多个监听器的注册表。

每个 Subject 都是 Observable

  • 对于 Subject,你可以提供一个观察者并使用 subscribe 方法,就可以开始正常接收值。从观察者的角度而言,它无法判断 Observable 执行是来自普通的 Observable 还是 Subject 。在 Subject 的内部,subscribe 不会调用发送值的新执行。它只是将给定的观察者注册到观察者列表中,类似于其他库或语言中的 addListener 的工作方式。

每个 Subject 都是 Observer

  • Subject 是一个有如下方法的对象: next(v)、error(e) 和 complete() 。要给 Subject 提供新值,只要调用 next(theValue),它会将值多播给已注册监听该 Subject 的观察者们。

普通 Subject 没有缓存数据,订阅者在数据源发射数据之后订阅,是拿不到之前发射的值的,

1
2
3
4
5
6
7
8
9
10
11
12
const subject = new Subject()

// 订阅之前发射的值时拿不到的
subject.next('100')

// 订阅者在数据源发射数据之后订阅,拿不到之前的数据
subject.subscribe(text => console.log('subscribeA:', text))
subject.subscribe(text => console.log('subscribeB:', text))

// 订阅之后发射的值才能拿到
subject.next('200')
subject.next('300')

avatar

Subject 有几个子类,可以缓存部分或全部数据,在订阅时拿到数据执行处理,具体区别可以查看下面代码测试

BehaviorSubject

BehaviorSubject在创建时需要传递一个默认值,在订阅后会获取上一次发射的值

1
2
3
4
5
6
7
8
9
// BehaviorSubject 会存储最后一次发射的数据
const subject1 = new BehaviorSubject(0)

subject1.next(1000)
subject1.next(2000)
subject1.subscribe(val => console.log('BehaviorSubject subscribeA:', val))
subject1.next(3000)
subject1.subscribe(val => console.log('BehaviorSubject subscribeB:', val))
subject1.next(4000)

avatar

ReplaySubject

ReplaySubject会缓存所有数据,当有新的订阅者的时候,发射缓存的所有值

1
2
3
4
5
6
7
8
const subject2 = new ReplaySubject()

subject2.next(1000)
subject2.next(2000)
subject2.subscribe(val => console.log('ReplaySubject subscribeA:', val))
subject2.next(3000)
subject2.subscribe(val => console.log('ReplaySubject subscribeB:', val))
subject2.next(4000)

avatar

AsyncSubject

AsyncSubject 和 BehaviorSubject 一样只会存储最后一次发出的数据,但是 AsyncSubject 只会在 complete 时把数据发射出去

1
2
3
4
5
6
7
8
9
10
11
12
// AsyncSubject 和 BehaviorSubject 一样只会存储最后一次发出的数据,但是 AsyncSubject 只会在 complete 时把数据发射出去
const subject4 = new AsyncSubject()
subject4.next(1000)
subject4.next(2000)
subject4.subscribe(val => console.log('AsyncSubject subscribeA:', val))
subject4.next(3000)
subject4.subscribe(val => console.log('AsyncSubject subscribeB:', val))
subject4.next(4000)
subject4.complete(); // 只有在 complete 时把上一次缓存的值发射出去
// 会存储之前的值
subject4.subscribe(val => console.log('AsyncSubject subscribeC:', val))
subject4.next(5000) // 收不到 complete 之后的值

avatar

四种 Subject 有各自的特性,可以根据下表来做详细区分

avatar

Subject相关内容查看案例:RxJS 源码解读之 Subject

Schedulers – 调度器

调度器控制着何时启动 subscription 和何时发送通知。它由三部分组成:

  • 调度器是一种数据结构。 它知道如何根据优先级或其他标准来存储任务和将任务进行排序。

  • 调度器是执行上下文。 它表示在何时何地执行任务(举例来说,立即的,或另一种回调函数机制(比如 setTimeout 或 process.nextTick),或动画帧)。

  • 调度器有一个(虚拟的)时钟。 调度器功能通过它的 getter 方法 now() 提供了“时间”的概念。在具体调度器上安排的任务将严格遵循该时钟所表示的时间。

调度器可以让你规定 Observable 在什么样的执行上下文中发送通知给它的观察者。

总结

RxJS 是一个库,它通过使用 observable 序列来编写异步和基于事件的程序。可以把 RxJS 当做是用来处理事件的 Lodash 。RxJS 结合了 观察者模式、迭代器模式 和 使用集合的函数式编程,以满足以一种理想方式来管理事件序列所需要的一切。

Rxjs 可以处理多个数据对应的 complete 和 error 状态,但是 Rxjs 同时拥有 Next 方法,可以发射多个值,是对 Promise,callbacks,Web Workers,Web Sockets 进行统一的优化,一旦我们统一了这些概念后,将能更好地进行开发

Rxjs生态

Rxjs生态相对React,Vue,Angular等框架来说不算火,主要是因为学习成本比较高,但是各个框架都有对应的资源库支持,有兴趣可以详细研究

Rxjs使用场景

参考文章

Puppeteer 入门与使用

by zhaowei 2019/12/19

图片来源:https://pptr.dev/images/pptr.png

[TOC]

前言

在学习Puppeteer之前,我们先来了解下什么是Headless Chrome,Headless Chrome能做些什么

Headless是Chrome在17年自行开发的特性,支持以下功能:

  1. 在无界面的环境中运行 Chrome
  2. 通过命令行或者程序语言操作 Chrome
  3. 无需人的干预,运行更稳定
  4. 在启动 Chrome 时添加参数 –headless,便可以 headless 模式启动 Chrome
1
2
3
4
5
6
7
8
9
10
alias chrome="/Applications/Google\ Chrome.app/Contents/MacOS/Google\ Chrome"

# Mac OS X 命令别名
chrome --headless --remote-debugging-port=9222 --disable-gpu

# 开启远程调试
chrome --headless --disable-gpu --dump-dom https://www.baidu.com

# 获取页面 DOM
chrome --headless --disable-gpu --screenshot https://www.baidu.com

正文

基于Chrome Handless特性,Chrome推出了Puppeteer node包,是对Chrome的无界面版本以及对其进行操作的js接口封装,通过调用Chrome DevTools开放的接口与Chrome通信,使得我们可以非常方便的操作Chrome。

Puppeteer 简介

Puppeteer 是一个node库,他提供了一组用来操纵Chrome的API, 通俗来说就是一个 headless chrome浏览器 (当然你也可以配置成有UI的,默认是没有的)。既然是浏览器,那么我们手工可以在浏览器上做的事情 Puppeteer 都能胜任, 另外,Puppeteer 翻译成中文是”木偶”意思,所以听名字就知道,操纵起来很方便,你可以很方便的操纵她去实现:

  1. 生成网页截图或者 PDF
  2. 高级爬虫,可以爬取大量异步渲染内容的网页
  3. 模拟键盘输入、表单自动提交、登录网页等,实现 UI 自动化测试
  4. 捕获站点的时间线,以便追踪你的网站,帮助分析网站性能问题

Chrome Headless 特性,意思是在无界面的环境下运行Chrome,可以通过命令行或者程序语言操作Chrome

Puppeteer 安装

在安装Puppeteer包时,可能会遇到chromium安装失败的情况(原因你懂的),遇到这种情况,我们可以自行下载 chromium 浏览器进行安装

1
cnpm install puppeteer-chromium-resolver

成功后会显示安装路径,记住这个安装路径,在后面会用到

浏览器安装成功之后,继续安装 puppeteer 时可以通过set PUPPETEER_SKIP_CHROMIUM_DOWNLOAD 跳过下载过程

1
2
npm set PUPPETEER_SKIP_CHROMIUM_DOWNLOAD true
npm install puppeteer

不过更推荐安装 puppeteer-core,不会下载 chromium,而且包体积会更小

1
npm install puppeteer-core

玩转 Chrome Handless

puppeteer安装完成之后,我们就可以利用puppeteer 操作 Chrome,详细api可以查看操作文档:Puppeteer

首先打开浏览器并跳转到指定页面,需要用到上面 chromium 的安装路径

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
const puppeteer = require('puppeteer-core');

const launch_options = {
// 启动模式: true 无头模式
headless: false,
// 可运行 Chromium 或 Chrome 可执行文件的路径,这里就是上面 Chromium 的安装路径
executablePath:
"安装路径"
};

(async () => {
// 开启浏览器
const browser = await puppeteer.launch(launch_options)
// 开启一个tab页
const page = await browser.newPage()
// 跳转到百度首页
await page.goto('http:/www.baidu.com')
// 关闭页面
await page.close()
// 关闭浏览器
await browser.close()
})();

我们这里为了查看效果配置了headless为false,表示不使用无头模式,可以用来调试项目,其他关于 browser和page的配置可以查看 文档。

运行之后会打开浏览器并新建tab页,跳转到百度首页,之后会自动关掉

浏览器运行起来之后我们就可以来做下面这些事情了

生成网页截图或者PDF

网页截图在Chrome浏览器中是可以调用命令导出png图片的,f12打开开发面板,ctrl + shift + p打开命令行窗口,输入 screenshot 关键字搜索命令,就可以截取当前页面了

而通过代码也是很方便的截图

1
2
3
4
// 截图
await page.screenshot({
path: './baidu.png'
})

运行之后会在当前目录下生成 baidu.png,当然他还支持有页面任意范围的截图,其他详细配置可以查看 文档

而puppeteer导出pdf也非常简单,一行代码搞定

1
2
3
4
// pdf
await page.pdf({
path: './baidu.pdf'
})

在导出pdf时,可以通过设置css的媒体模式为 screen 优化导出效果,具体可以查看 文档

1
await Global.page.emulateMediaType('screen'); // 'screen', 'print' 和 null

运行完毕当前目录下就会生成 pdf 文件,但要注意的是 puppeteer 导出pdf必须是在无头模式下,即 headless 必须为 true,否则会报错。关于其他导出pdf的配置可以查看 文档

当然如果是需要导出doc或execl等文件,可以运行 js 脚本进行下载,可以通过设置指定下载目录,保存我们的文件

1
2
3
4
5
// 指定文件下载路径
await Global.page._client.send('Page.setDownloadBehavior', {
behavior: 'allow',
downloadPath: "下载路径", // 建议使用绝对路径
})

高级爬虫,可以爬取大量异步渲染内容的网页

利用puppeteer可以在不打开浏览器(即无头模式下)对网站中的页面爬虫爬取数据,更多的是拉取页面上的图片、媒体的等各种资源,网上案例很多,可自行查阅。

我们目前项目里面用到的是插入markdown渲染之后的html代码,并插入执行js脚本,主要用到下面几个方法:

插入html文档

1
2
3
4
5
6
7
8
9
// 设置html content
await Global.page.setContent(html, {
waitUntil: 'domcontentloaded'
})

// 插入以来的css代码段或者文件
await Global.page.addStyleTag({
path: path.resolve(__dirname, 'assets/markdown.css'),
});

向指定dom插入html片段

1
2
3
4
// 指定位置插入插入 html 片段
await Global.page.$eval('#content', (dom, html) => {
dom.innerHTML = html
}, html);

插入js外部库

1
2
3
await Global.page.addScriptTag({
path: path.resolve(__dirname, 'lib/waterMask.js'),
});

执行js脚本

1
2
3
4
5
6
7
await Global.page.evaluate((text) => {
if (window.waterMark) {
window.waterMark({
text
});
}
}, watermark)

需要注意的是 page.evaluate* 等方法都是可以传递外部参数的,插入的js脚本是运行在浏览器端,在访问一些库如jquery等时可能需要显示使用 window 命名空间,否则node可能会校验变量为定义。如果内部返回的是Promise,node端也是可以拿到数据的

模拟键盘输入、表单自动提交、登录网页等,实现 UI 自动化测试

模拟键盘输入、表单自动提交、登录网页等,实现 UI 自动化测试说白了就是定位到页面元素,触发dom事件,使用 puppeteer 中 page 的下面方法可以很轻松的做到,具体可自行查阅

1
2
3
4
5
page.$(selector)
page.$$(selector)
page.$$eval(selector, pageFunction[, ...args])
page.$eval(selector, pageFunction[, ...args])
page.$x(expression)

表单自动提交等案例如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
// 自动填充表单数据
const name = 'mayanjun@haowumc.com';
await page.type('.text.pristine.untouched', name, {delay: 0});
const pwd = '密码';
await page.type('.text.pristine.untouched', pwd, {delay: 1});

// 触发表单提交
const inputElement = await page.$('input[type=submit]');
await inputElement.click();

// 等待浏览器跳转
await page.waitForNavigation();

console.log(page.url());
await page.goto(url, {
waitUntil: 'networkidle2' // 网络空闲说明已加载完毕
});

关于 page.$*的各种api,用法jquery差不多,有兴趣可以查看 文档

捕获站点的时间线,以便追踪你的网站,帮助分析网站性能问题

chrome自身带有监控工具,可以查看收集到各种资源请求的结果、耗时操作以及错误警告等信息,通过 puppeteer 的 Events api可以监听到页面中的很多信息,很方便的帮助我们追踪网站、帮助分析网站性能问题,也有很多前端团队基于 puppeteer 做自己的监控工具,更多信息可以查看 文档。

总结

chrome浏览器功能很强大,基于 chrome 的 Headless 特性在node端也可以模拟实现前端页面中的各种神奇操作,达到我们的预期效果,但同时Headless Chrome 会占用大量的资源,特别是跑其他应用的服务器上时,无头浏览器的行为难以预测,目前线上应用更多的都是使用 docker 来管理 Chrome,构建定制镜像,在容器中运行,确保 Chrome 的稳定状态。

参考文章